
Gestione del Look
I dailies (il girato giornaliero) ben corretti cromaticamente e con un look curato imprimono nella mente del regista, dei produttori, dello studio, dei montatori e di tutti i membri del team una chiara percezione dell’aspetto visivo desiderato per il progetto. Questo rappresenta un passaggio fondamentale per ottenere un risultato finale che rispecchi fedelmente la visione del direttore della fotografia.
Una volta che il team creativo si abitua al look dei dailies, modificarlo successivamente diventa spesso molto difficile. Non è raro che il direttore della fotografia non sia presente o non venga coinvolto nella sessione finale di color grading: per questo motivo, curare attentamente la gestione del look durante la produzione è il modo migliore per garantire che l’aspetto finale delle immagini corrisponda alla visione originale.
La Situazione Attuale
I “giorni difficili” legati all’invenzione e allo sviluppo delle prime cineprese digitali sono ormai alle spalle. Abbiamo superato una fase di transizione ed è iniziata l’era matura della cinematografia digitale. Il periodo pionieristico, caratterizzato dai rischi tipici degli “early adopter” (i primi utilizzatori di nuove tecnologie), è terminato: oggi le cineprese digitali dotate di sensore CMOS con pattern Bayer a chip singolo dominano il mercato cinematografico.
Gli strumenti della cinematografia digitale sono ormai da tempo nelle mani dei professionisti e hanno avuto modo di maturare ed evolversi.
La buona notizia è che da questo punto in poi possono solo migliorare. Oggi questi strumenti non solo eguagliano le potenzialità che offriva la pellicola, ma in alcuni aspetti superano persino le sue capacità di riproduzione dell’immagine. Questo progresso comporta anche una responsabilità: è fondamentale formarci adeguatamente per padroneggiare l’uso quotidiano di questi strumenti professionali.
Come Funzionano le Cineprese Digitali
La cinematografia è l’arte di catturare, registrare e manipolare immagini in movimento, sia su pellicola che tramite sensori digitali.
Il cuore di questa disciplina consiste nel saper bilanciare la gamma tonale delle scene inquadrate davanti all’obiettivo con la capacità di registrazione del supporto sensibile (pellicola o sensore) posto dietro l’obiettivo. L’obiettivo è catturare e registrare quella gamma tonale in modo artisticamente efficace.
La Risposta Visiva Umana alla Luce
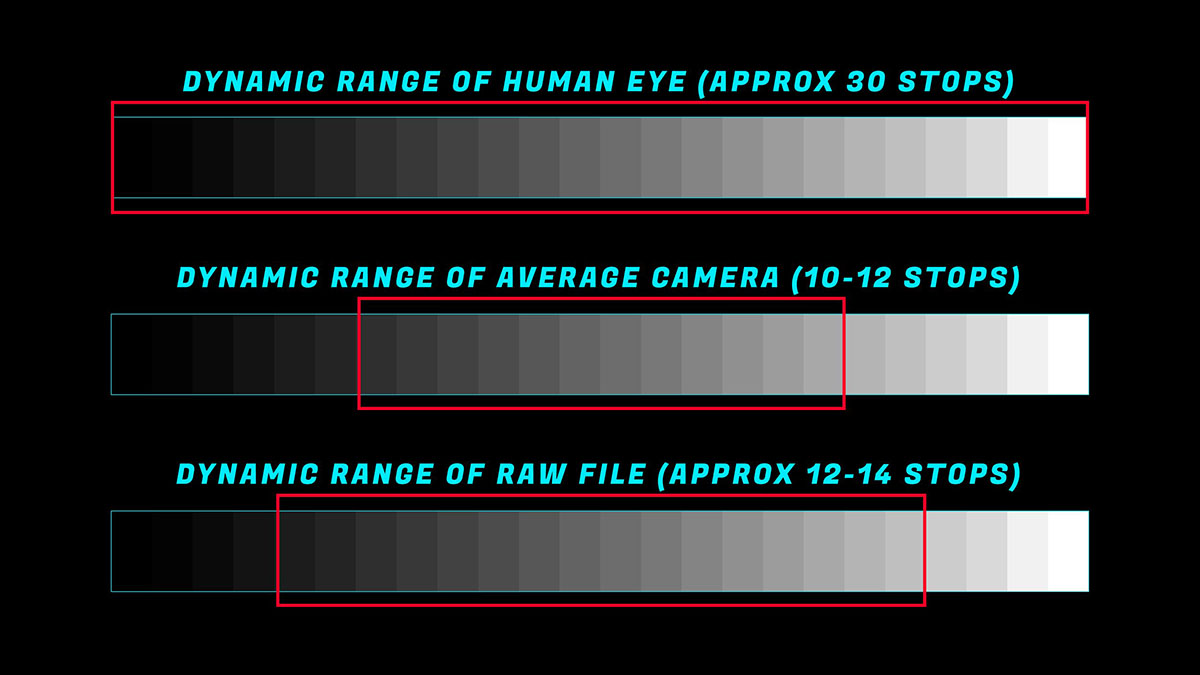
Il modo in cui i nostri occhi percepiscono l’intensità luminosa non è lineare. L’occhio umano è capace di adattarsi a una gamma straordinariamente ampia di intensità luminose: la sorgente più luminosa che possiamo tollerare è oltre dieci miliardi di volte più intensa della sorgente più debole che riusciamo a percepire. Tuttavia, la nostra percezione della luce funziona in modo simile a come la pellicola negativa registra la luce.
Sia la visione umana che la pellicola negativa rispondono al raddoppio (o al dimezzamento) dell’intensità luminosa percependolo come una variazione di circa uno stop nella luminosità.
Entrambi i sistemi – la visione umana e l’esposizione dei cristalli di alogenuro d’argento nell’emulsione fotografica – seguono un comportamento non lineare che può essere descritto approssimativamente attraverso una funzione logaritmica o una legge di potenza. Lo psicofisico Stanley Smith Stevens, studiando le leggi psicofisiche dell’intensità luminosa, ha dimostrato che la risposta visiva umana alla luminosità segue effettivamente una funzione molto simile a quella logaritmica.
- 1-bit color significa acceso/spento, quindi solo due toni: bianco e nero
- 10-bit color significa 2 elevato alla decima potenza, cioè 2¹⁰ = 1024 tonalità per ciascun colore (rosso, verde e blu)
Dei 1024 valori disponibili nella codifica a 10 bit, i 4 valori più alti e i 4 più bassi sono riservati per altri scopi tecnici. Quindi, in pratica, il colore RGB a 30 bit (10 bit per canale) offre circa 1015 valori per il rosso, 1015 per il verde e 1015 per il blu, per un totale di oltre un miliardo di possibili sfumature di colore (1.045.678.375 per la precisione).
-
1-bit color significa acceso/spento, quindi una coppia binaria di toni: bianco/nero.
-
10-bit color significa 2 alla decima potenza, cioè 2¹⁰ = 1024 tonalità per ciascun colore (rosso, verde e blu).
Dei 1024 valori disponibili nella codifica a 10 bit, i 4 valori più alti e i 4 più bassi vengono riservati ad altri dati. Quindi, approssimativamente, il colore RGB a 30 bit offre 1015 valori per il rosso, 1015 per il verde e 1015 per il blu, che equivalgono a 1.045.678.375 possibili sfumature di colore.
A ciascun fotosito viene assegnato un valore numerico digitale che indica l’intensità tonale per il rosso, il verde o il blu. Il numero totale di valori tonali disponibili è chiamato profondità in bit del colore (color bit depth). Maggiore è la profondità in bit, più numerosi sono i valori tonali disponibili e quindi minori sono le differenze di colore appena percettibili.
Nel cinema digitale, la profondità in bit indica il numero di bit digitali utilizzati per codificare ciascun componente di colore di un singolo pixel. Un bit è una cifra binaria che può assumere uno di due stati, comunemente rappresentati come 0/1, vero/falso, sì/no, +/− oppure acceso/spento. Ad esempio:

Come i Sensori Catturano la Luce
Per oltre cent’anni, la pellicola fotografica ha utilizzato minuscoli cristalli fotosensibili di alogenuro d’argento per registrare le immagini. Quando questi cristalli venivano esposti alla luce e poi sviluppati chimicamente, si trasformavano in argento metallico scuro, creando le aree più scure del negativo. In pratica: più luce ricevevano, più scuri diventavano.
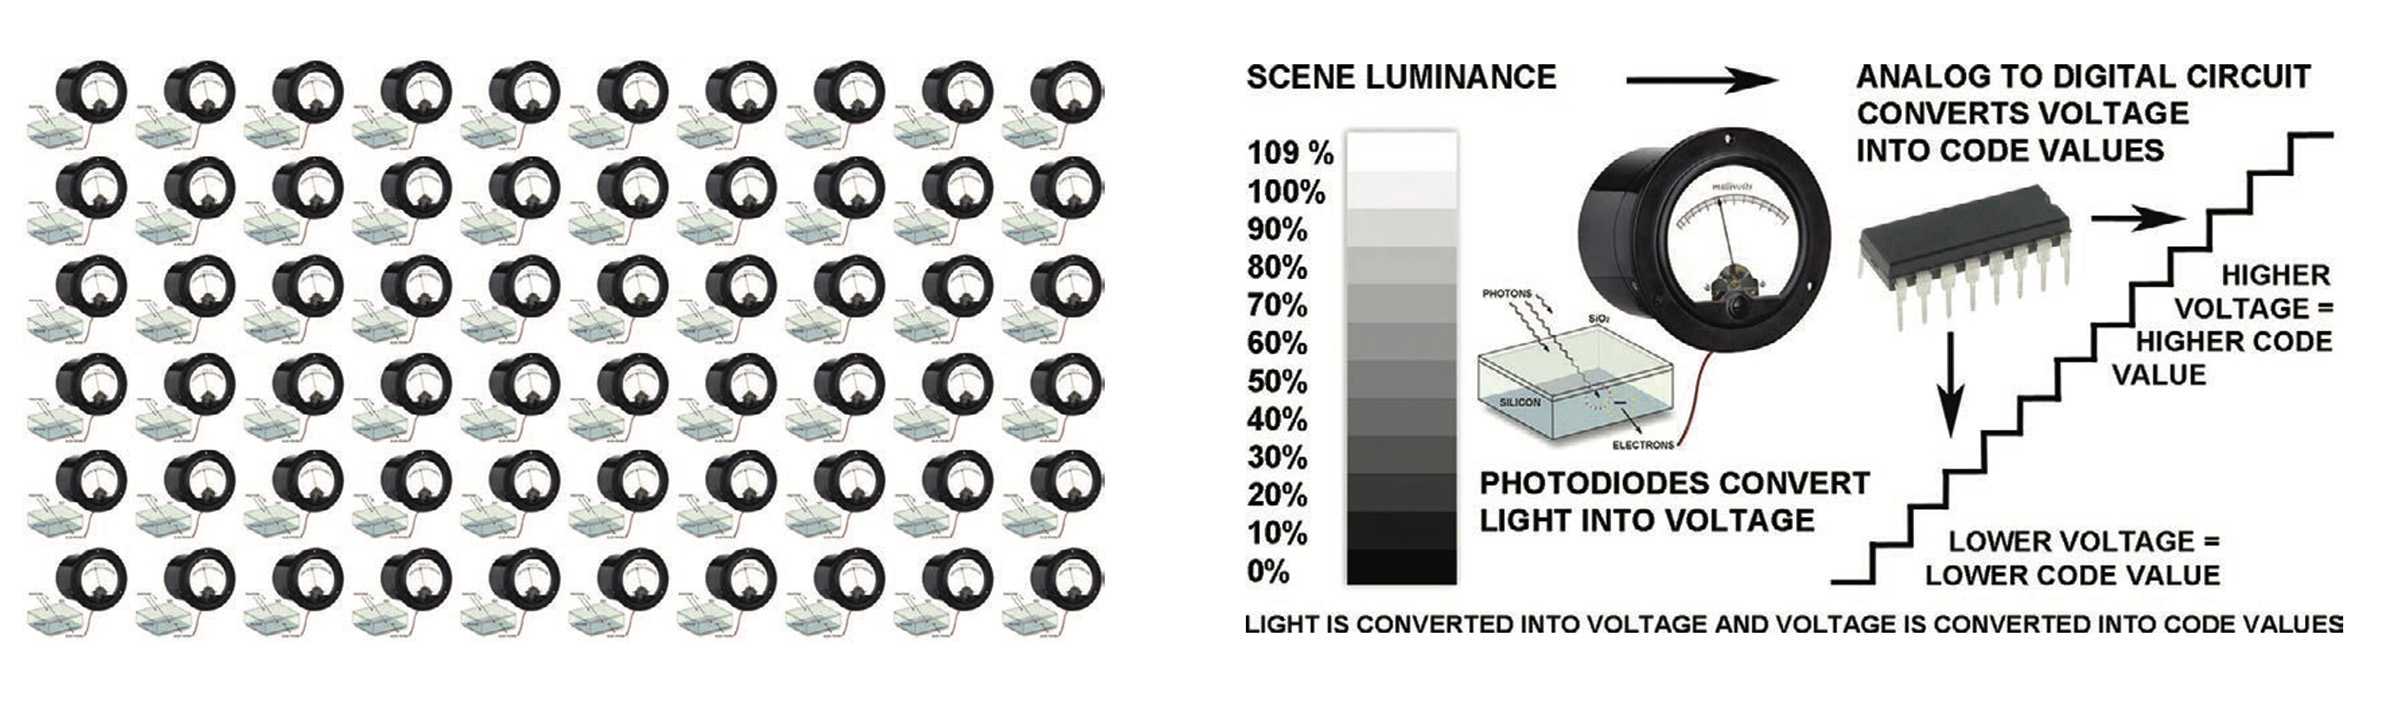
I sensori digitali funzionano in modo diverso ma con un principio simile. Utilizzano milioni di microscopici componenti elettronici chiamati fotodiodi – dei veri e propri “collettori di luce” in silicio. Quando la luce li colpisce, questi fotodiodi permettono agli elettroni di accumularsi, generando una carica elettrica. La fotocamera misura questa carica una volta per ogni fotogramma, poi la scarica e azzera il contatore, pronta per il fotogramma successivo.

La Griglia del Sensore
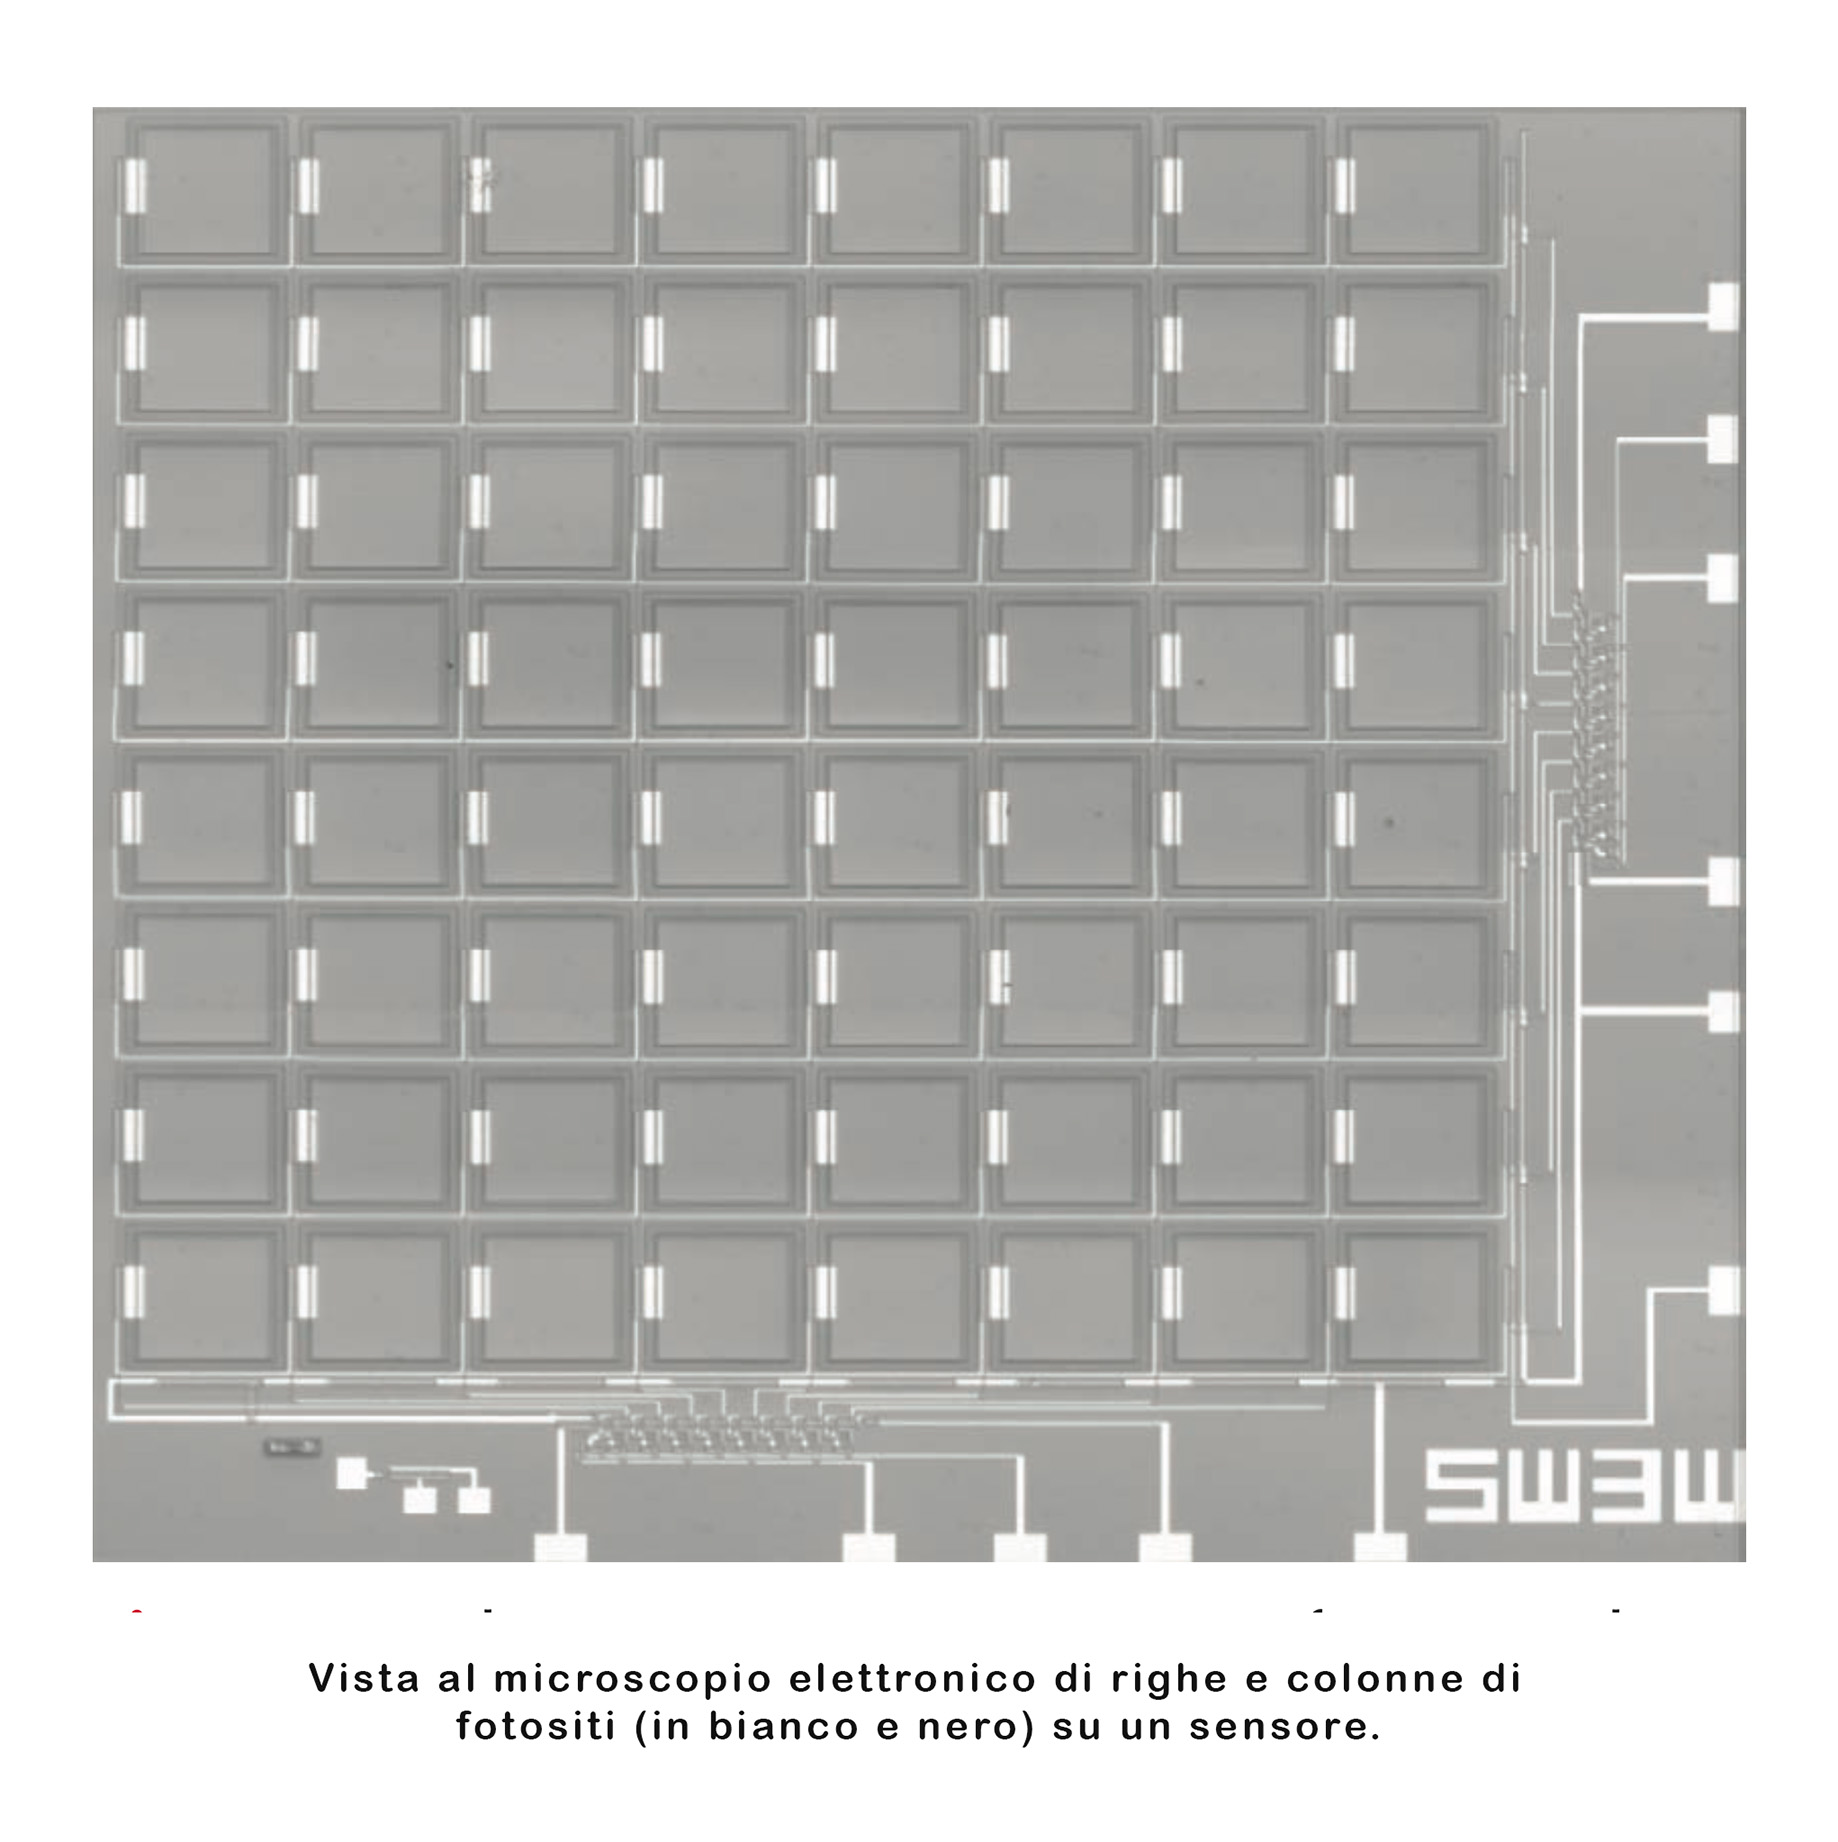
Un sensore digitale è costituito da una griglia ordinata di fotodiodi disposti in righe e colonne, come una scacchiera microscopica. Ogni fotodiodo accumula carica elettrica mentre i raggi luminosi provenienti dall’obiettivo formano un’immagine sulla superficie del sensore.
Per capire meglio questo meccanismo, possiamo pensare all’elettricità statica che si accumula quando camminiamo su un tappeto con le scarpe da ginnastica in una giornata secca: più camminiamo, più carica accumuliamo. Allo stesso modo, più luce colpisce un fotodiodo, maggiore sarà la carica elettrica accumulata; con meno luce, la carica sarà minore.
Photosites e Sensels: I Mattoncini dell’Immagine Digitale
Nel linguaggio tecnico dell’imaging digitale, ogni singolo fotodiodo viene chiamato photosite (sito fotografico), mentre il segnale elettrico che genera è detto sensel (elemento sensore). I sensori delle fotocamere moderne contengono migliaia di righe e colonne di photosites che lavorano come microscopici raccoglitori di luce indipendenti, convertendo la luce in segnale elettrico, photosite per photosite, fotogramma per fotogramma. Questa griglia ordinata di photosites è chiamata raster.
C’è però un limite importante: questi photosites non sono in grado di distinguere autonomamente i colori. Possono solo misurare l’intensità (cioè la quantità) di luce che li colpisce e convertirla in un segnale elettrico. Per ottenere informazioni sui colori, è necessario dotarli di un meccanismo aggiuntivo. Approfondiremo questo aspetto più avanti nel capitolo.
K e Risoluzione: Attenzione alle Etichette
Quando un produttore dichiara che una fotocamera è “4K”, si riferisce al numero di photosites presenti lungo la dimensione orizzontale del sensore. La “K” sta per migliaia (dal prefisso “kilo”): una fotocamera 4K ha quindi almeno 4.096 photosites in orizzontale.
Tuttavia, attenzione: il numero di photosites non corrisponde necessariamente alla risoluzione effettiva delle immagini prodotte dalla fotocamera. Come vedremo nel prossimo capitolo, i photosites non sono la stessa cosa dei pixel dell’immagine finale.
Conversione da Analogico a Digitale (A/D)
Durante il processo di conversione analogico-digitale (A/D), la carica elettrica accumulata in ciascun fotosito viene trasformata in codice binario tramite un circuito di campionamento. Nelle immagini digitali, ogni fotosito è rappresentato da un valore numerico discreto che rimane costante per l’intera durata del fotogramma.
Il processo che trasforma le cariche elettriche dei fotositi in valori numerici è chiamato quantizzazione. Al termine di ogni fotogramma, la carica di ciascun fotosito viene trasferita al convertitore analogico-digitale. Il valore numerico risultante, chiamato campione, rappresenta la quantità di carica accumulata durante il tempo di esposizione. Essendo valori numerici, questi campioni possono essere archiviati nella memoria del computer e salvati su disco come dati digitali.
Codifica della Luminanza in Valori Numerici
Il sensore risponde alla luce in modo lineare: con il doppio della luce si ottiene il doppio della carica elettrica, con metà della luce si ottiene metà della carica. Tuttavia, se assegniamo valori numerici lineari a queste cariche lineari, emergono rapidamente dei problemi.
La Figura sotto mostra un sistema di codifica lineare in cui la luminosità della scena viene misurata su una scala da 0 a 1 (dove 0 rappresenta il nero totale e 1 il bianco massimo). In questo schema, ogni valore di luminosità viene convertito direttamente in un numero digitale seguendo una relazione proporzionale: se la luce raddoppia, raddoppia anche il valore digitale

Il problema della codifica lineare
L’intervallo di luminanza della scena che va da 1 a 0,5 rappresenta una differenza di uno stop, cioè un dimezzamento della luce (fattore 2). In uno schema di codifica lineare a 10 bit, questo intervallo corrisponde ai valori da 1024 a 512, il che significa che allo stop più luminoso vengono assegnati 512 valori di codice discreti. Scendendo da 0,5 a 0,25 di luminanza abbiamo ancora uno stop, ma qui sono disponibili solo 256 valori di codice (da 512 a 256). Nell’intervallo successivo, da 0,25 a 0,125, abbiamo di nuovo uno stop ma con soli 128 valori disponibili (da 256 a 128). Continuando, da 0,125 a 0,0625 troviamo ancora uno stop con appena 64 valori di codice (da 128 a 64). Il quinto stop sotto 1 dispone di 32 valori, il sesto di 16, il settimo di 8, l’ottavo di 4, il nono di 2, e il decimo stop può essere rappresentato con un unico valore di codice.
Il problema è evidente: con uno schema lineare diretto avremmo valori più che sufficienti per rappresentare il primo stoppiù luminoso, ma valori insufficienti per le zone più scure della curva di esposizione. Nella codifica lineare, infatti, più la luminanza è bassa, minore è il numero di valori disponibili per rappresentarla.
Proprio per questa ragione non utilizziamo uno schema lineare per codificare immagini a 10 bit. Il difetto principale di questo approccio è che, mentre lo stop più luminoso dispone di valori abbondanti, gli ultimi sei stop ricevono troppo pochi valori per essere riprodotti con accuratezza. Questo significa che dobbiamo distribuire i valori di codice disponibili in modo molto più attento e appropriato per ogni stop di luce, in modo da utilizzare i bit disponibili in maniera più efficiente.
Dato che la percezione visiva umana della luminosità segue una funzione logaritmica o di potenza, è più sensato codificare le immagini digitali provenienti dai sensori utilizzando proprio una funzione logaritmica o di potenza. In questo modo la codifica si adatta meglio al modo in cui l’occhio umano percepisce realmente la luce.
La “Just Noticeable Difference” (JND) e la “Square Root Integral” (SQRI)
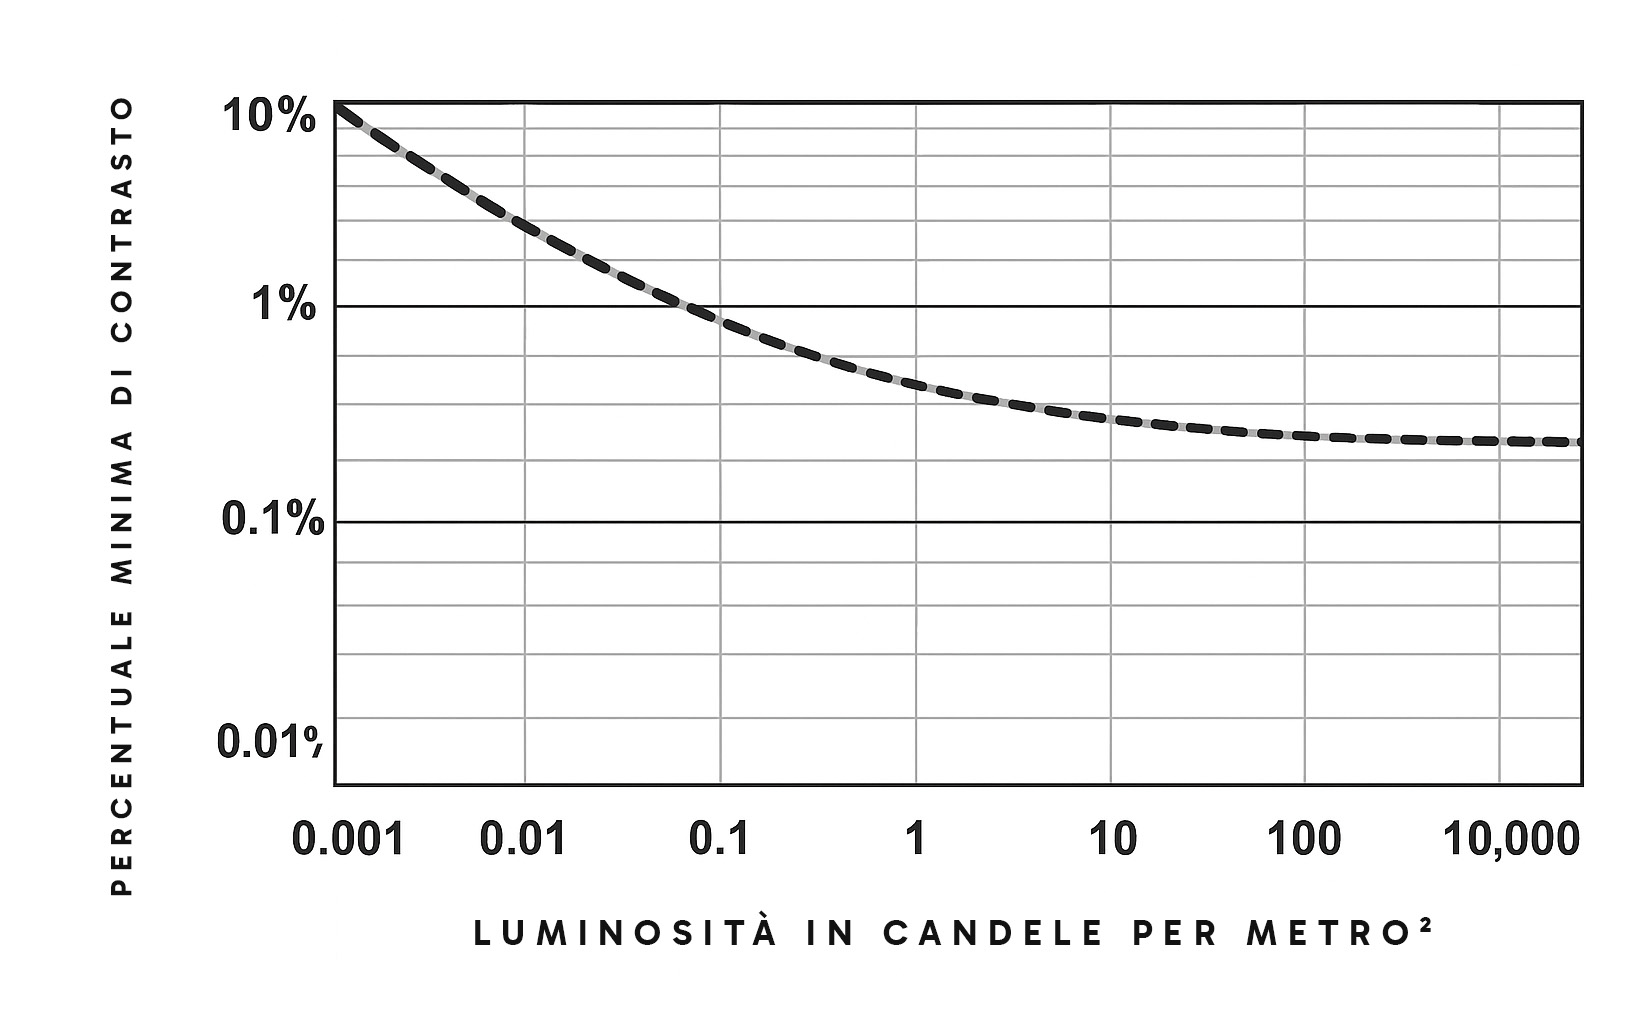
Quanti valori di codice (cioè quanti passaggi discreti di luminanza digitale) sono necessari per garantire che la quantizzazione non sia mai visibile in un’immagine lungo l’intero intervallo dinamico della videocamera? La risposta dipende dalla sensibilità del sistema visivo umano al contrasto, che è limitata. Se due livelli di grigio sono sufficientemente vicini in luminanza, la differenza diventa indistinguibile per l’occhio umano. Inoltre, la capacità di distinguere differenze tonali varia lungo l’intervallo che va dai toni scuri ai toni chiari.
Numerose ricerche scientifiche hanno studiato quanti livelli di colore l’occhio umano possa effettivamente distinguere nelle immagini. La soglia di questa capacità è descritta dal concetto di Just Noticeable Difference (JND), ovvero “differenza appena percettibile”. Nelle immagini, una JND rappresenta la minima variazione di colore o tonalità necessaria affinché un osservatore umano percepisca una differenza tra due colori o tonalità adiacenti almeno la metà delle volte.
Questo concetto è fondamentale perché, se utilizziamo uno schema di codifica con meno valori di codice rispetto alle JND per ogni stop di luce, le sottili gradazioni di colore vengono percepite come bande distinte. Questo fenomeno, chiamato color banding o aliasing cromatico, riduce significativamente la fedeltà della riproduzione dell’immagine originale e compromette l’esperienza visiva. Il numero di JND per stop di luce varia in base al colore e alla luminanza: l’occhio è più tollerante verso differenze maggiori nei toni scuri rispetto ai toni chiari.
Come regola generale, uno schema di codifica dovrebbe prevedere circa 60–70 valori di codice per stop di luce nelle gamme tonali intermedie. La distribuzione ottimale dei valori per stop varia passando dai toni scuri (dove sono ammesse variazioni percentuali più ampie di contrasto) ai toni chiari (dove sono richieste variazioni percentuali molto più piccole). Questa distribuzione segue quella che viene definita Barten ramp.
A ciascun fotosito viene assegnato un valore numerico digitale che indica l’intensità tonale per il rosso, il verde o il blu. Il numero totale di valori tonali disponibili è chiamato profondità in bit del colore (color bit depth). Maggiore è la profondità in bit, più numerosi sono i valori tonali disponibili e quindi minori sono le differenze di colore appena percettibili.
Nel cinema digitale, la profondità in bit indica il numero di bit digitali utilizzati per codificare ciascun componente di colore di un singolo pixel. Un bit è una cifra binaria che può assumere uno di due stati, comunemente rappresentati come 0/1, vero/falso, sì/no, +/− oppure acceso/spento. Ad esempio:
Codifica Lineare vs. Gamma/Logaritmica
Gli ingegneri televisivi dei primi anni dovettero risolvere un problema importante: la differenza tra come l’occhio umano percepisce la luminosità e come i dispositivi di visualizzazione la riproducevano. Questo accadde molto prima dell’avvento del cinema digitale. I vecchi monitor televisivi a tubo catodico (CRT) convertivano il segnale video in luce in modo non lineare. In pratica, quando veniva inviato un segnale di grigio medio (valore 0,5), sullo schermo appariva un grigio molto più scuro, circa il 22% dell’intensità del bianco anziché il 50% atteso.

La soluzione fu applicare al segnale una correzione matematica chiamata gamma, che compensa questa distorsione. La gamma è una funzione che regola il rapporto tra la luminanza codificata nel sistema e la luminanza effettiva che vogliamo vedere sullo schermo. Questa e altre funzioni simili, come le codifiche logaritmiche, vengono chiamate Opto-Electronic Transfer Functions (OETF), cioè funzioni di trasferimento optoelettroniche. La lettera greca gamma (γ) indica il fattore di correzione che permette di codificare la luce in modo efficiente per la registrazione e la distribuzione del video.
La gamma si manifesta visivamente come un cambiamento di contrasto. Modifica i valori tonali intermedi tra nero e bianco, mentre il nero puro (0,0) e il bianco puro (1,0) rimangono inalterati. Un valore gamma di 1 significa nessuna modifica; valori superiori a 1 aumentano il contrasto, mentre valori inferiori a 1 lo riducono.
La codifica gamma è un metodo non lineare utilizzato principalmente nel video RGB a 8 bit e a 10 bit per l’alta definizione (HDTV), come definito nello standard Rec. 709. In questo sistema, i valori RGB vengono codificati applicando un’elevazione a potenza di circa 0,45 alla luce lineare catturata dal sensore.
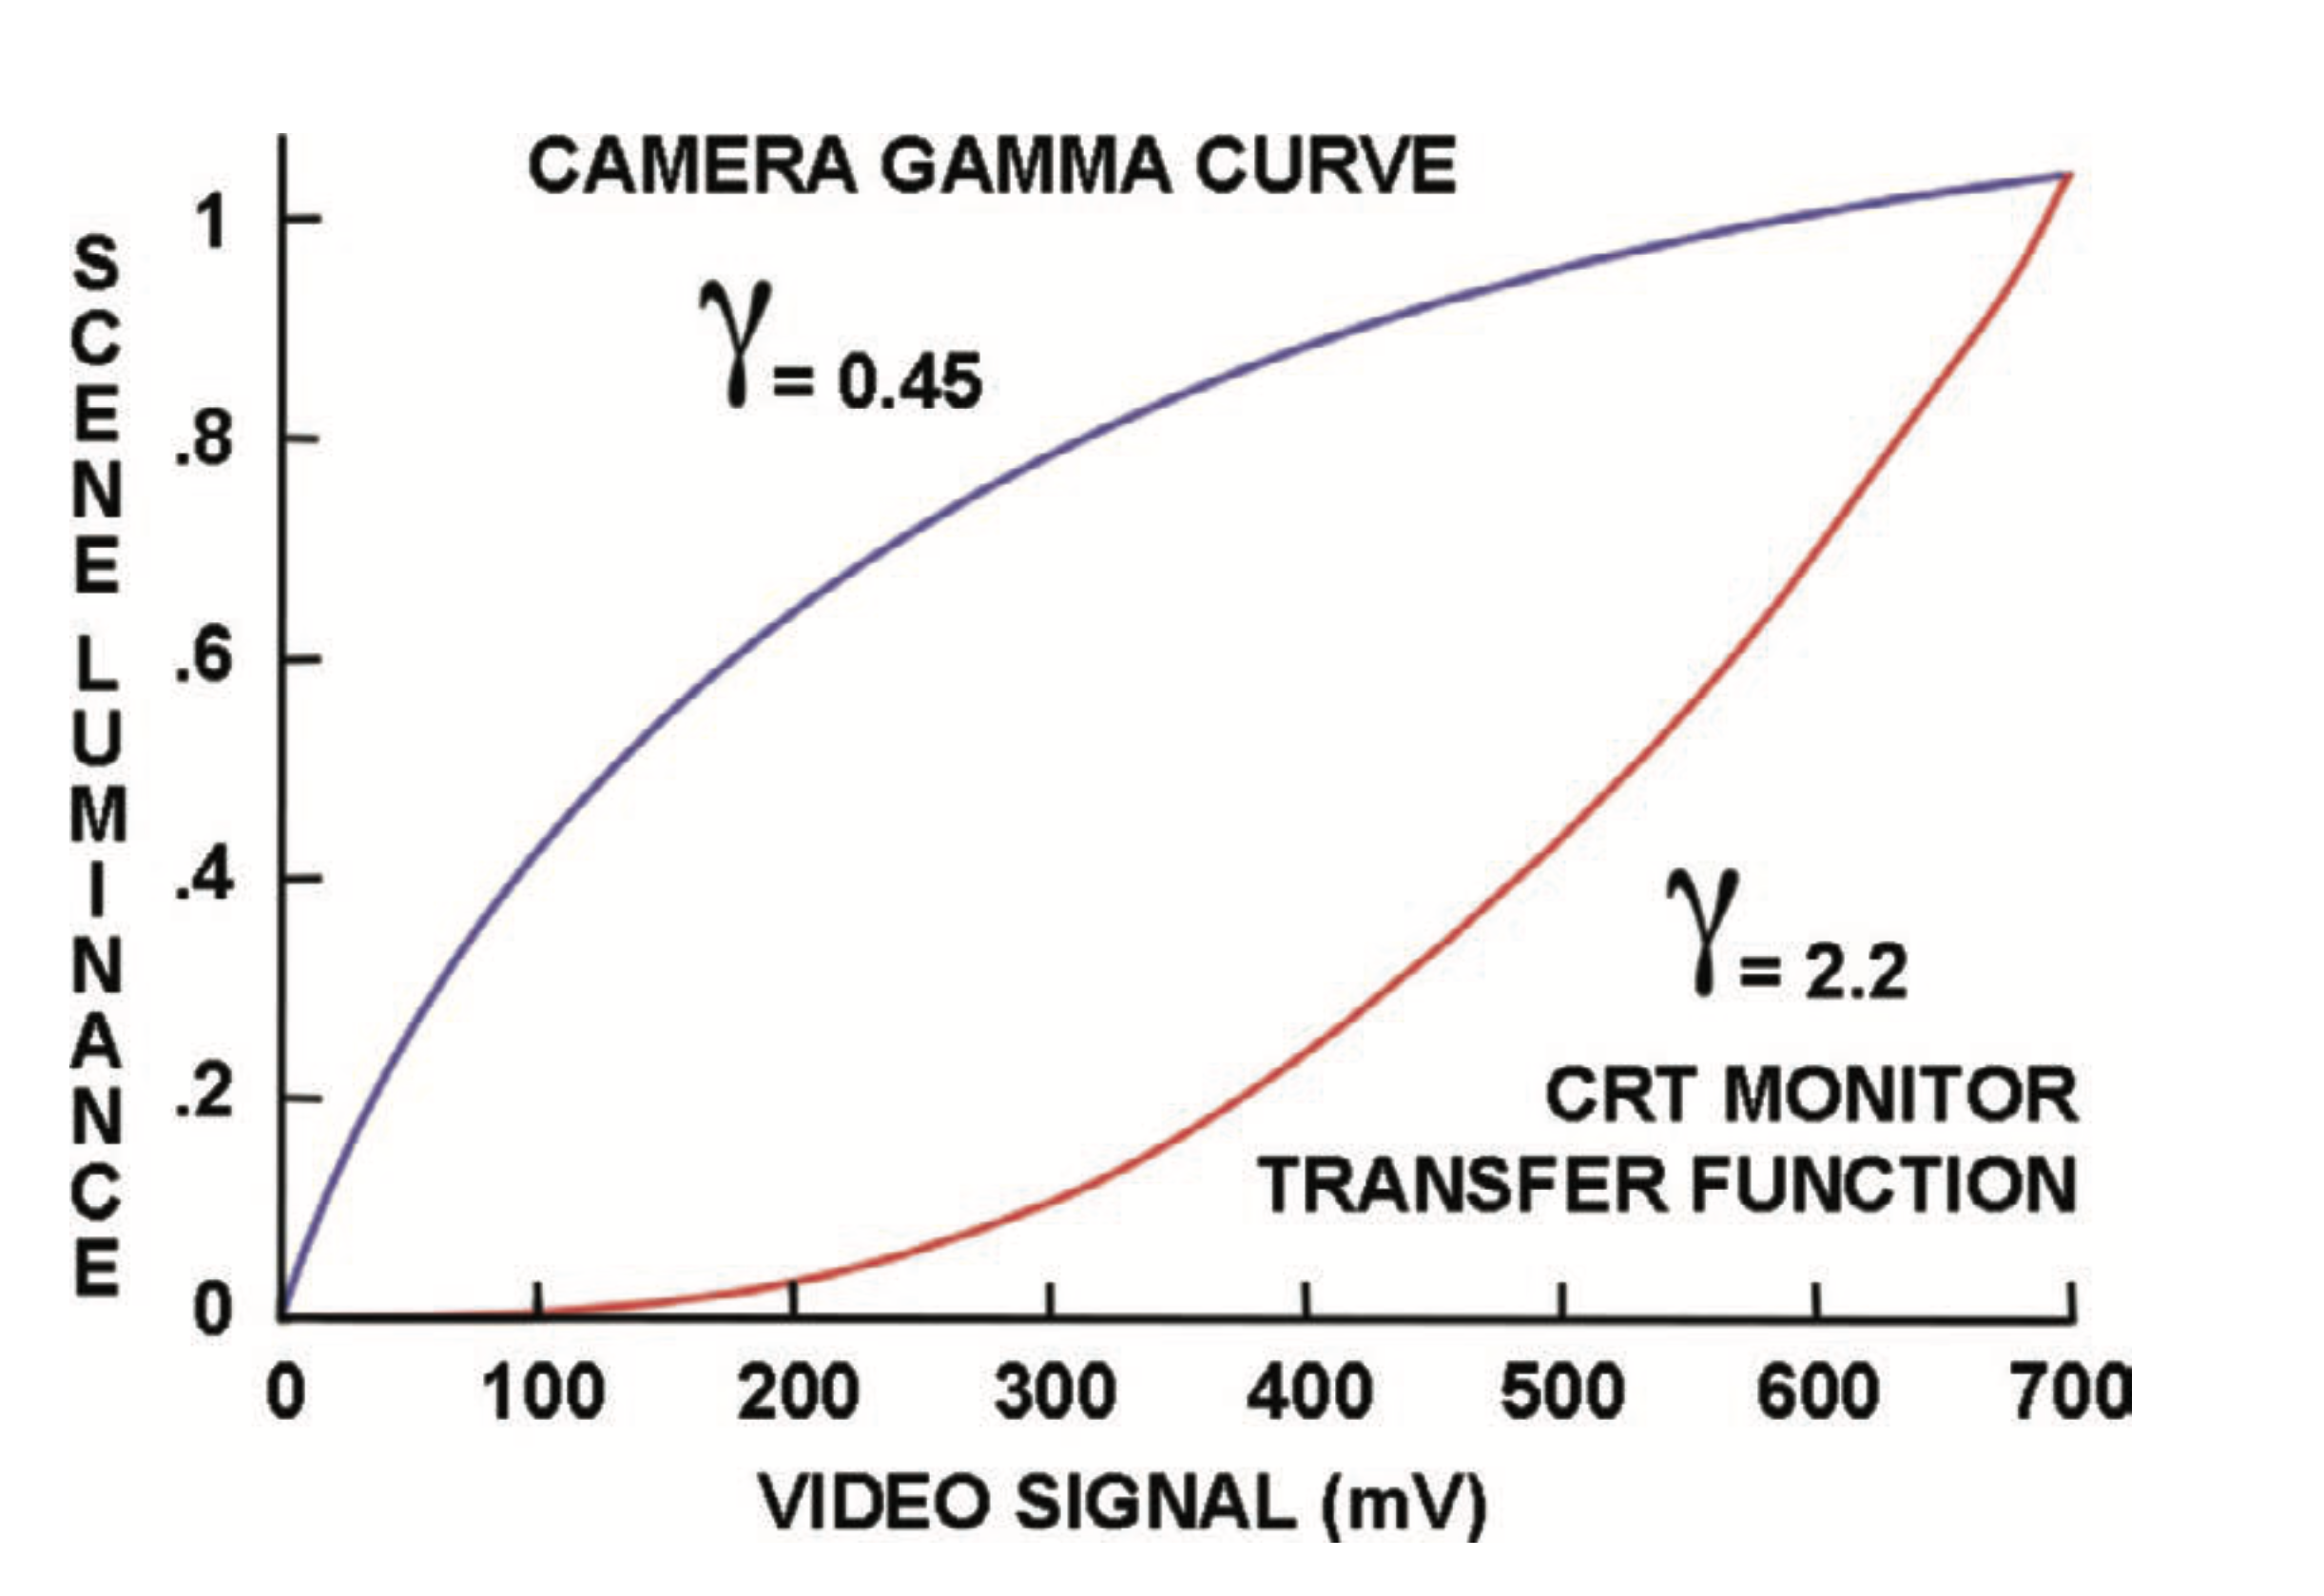
Durante l’elaborazione delle immagini e nelle operazioni di post-produzione (come compositing ed effetti digitali), viene spesso applicata una funzione inversa (OETF⁻¹) che riconverte i dati nel formato lineare originale, necessario per calcoli corretti.
Infine, quando il segnale viene inviato al monitor o al proiettore, viene applicata un’Electro Optical Transfer Function (EOTF) – come gamma 2.2, gamma 2.4, gamma 2.6, Perceptual Quantizer (PQ) o Hybrid Log Gamma (HLG) – che bilancia la correzione applicata in fase di codifica. Il risultato è un sistema visivamente lineare da capo a fondo: il segnale viene deliberatamente “distorto” durante la registrazione con la gamma, in modo che quando viene “distorto” al contrario dal display, l’osservatore percepisca la scala tonale corretta.
Raccomandazione ITU-R BT.709
La raccomandazione ITU-R BT.709 definisce una funzione di trasferimento per la codifica gamma dei segnali delle videocamere in alta definizione (HDTV). La funzione matematica gamma del Rec.709, con γ = 0,45, utilizza una combinazione intelligente: nei valori vicini allo zero usa una retta inclinata che si fonde gradualmente in una funzione di potenza, creando una curva con pendenza continua e senza salti.
Livelli di tensione nei segnali video HD
Nei segnali video HD, quando un fotosito viene esposto a un bianco diffuso al 100%, produce una tensione di uscita di 714 mV, che nel linguaggio tecnico video corrisponde a 100 IRE. Il segnale può spingersi fino al 109% di bianco (sovraesposizione), raggiungendo 785 mV o 109 IRE. Il livello del nero è fissato a 53,57 mV, pari a 7,5 IRE. (IRE è un’unità di misura dei segnali video compositi. Il nome deriva dall’Institute of Radio Engineers.)
Le diverse videocamere che implementano il Rec.709 producono risultati molto simili quando visualizzati su un monitor o con un oscilloscopio a forma d’onda. Le scale tonali in Rec.709 possono essere codificate in due intervalli differenti:
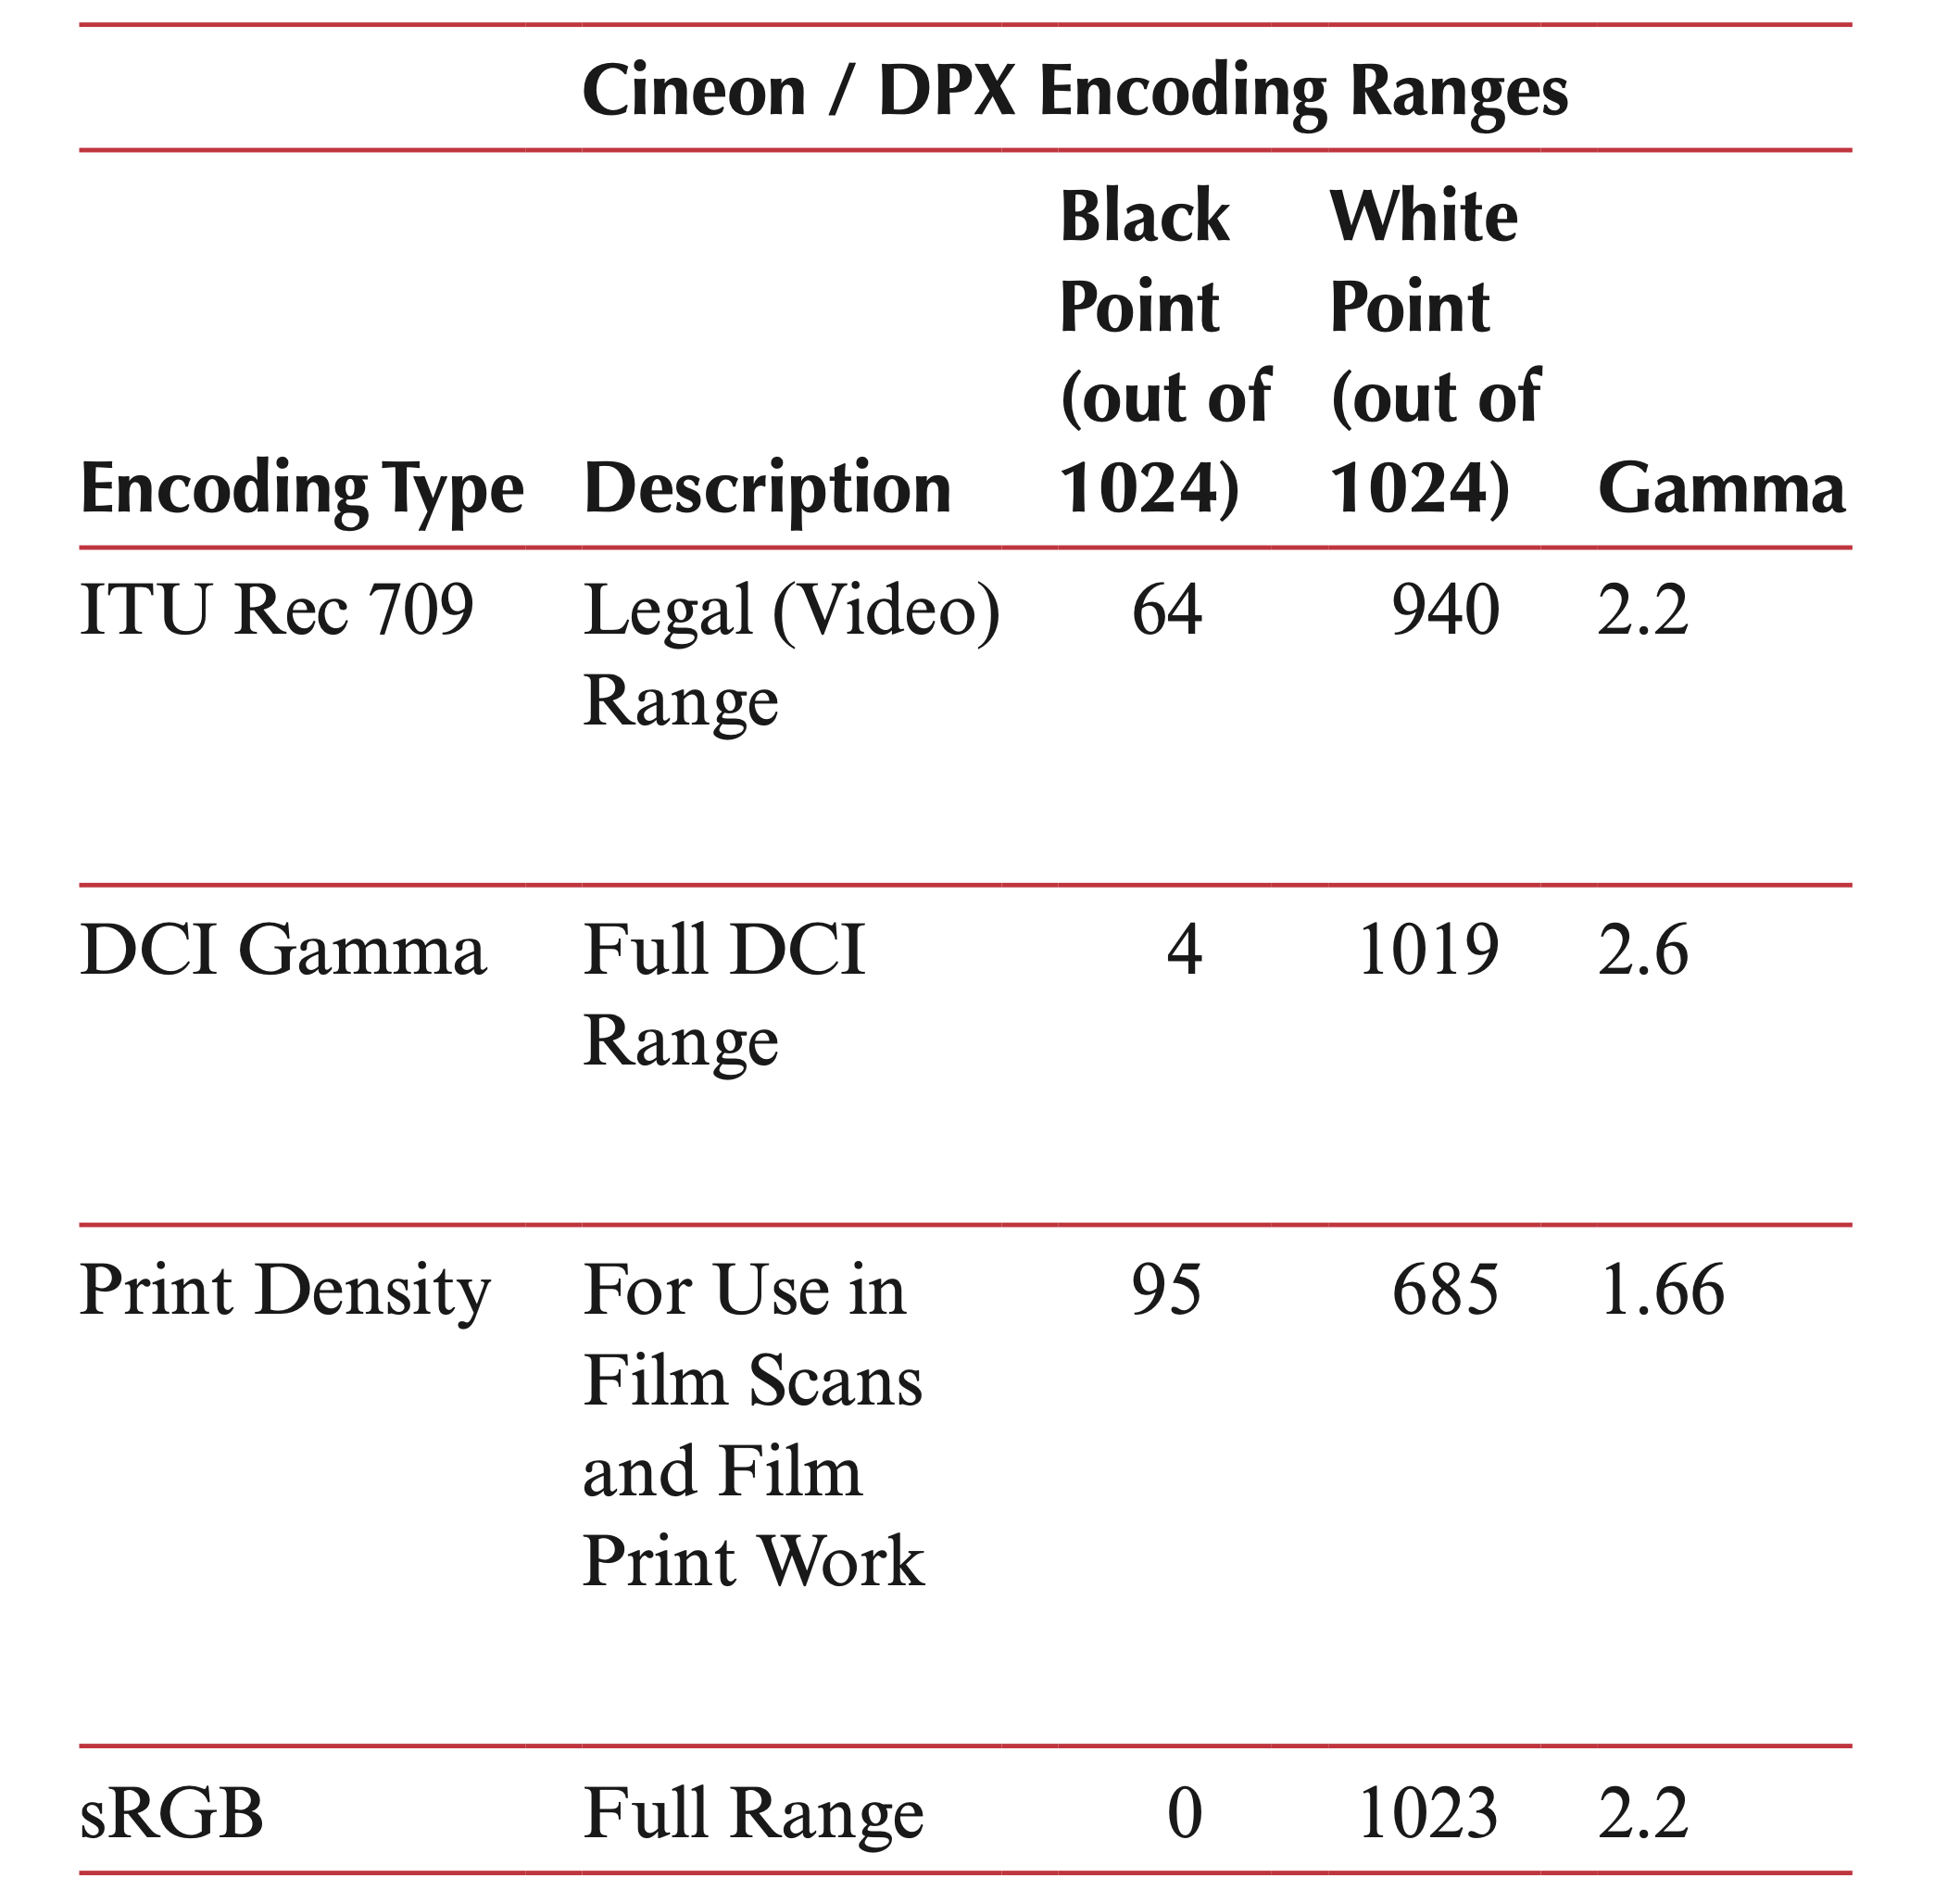
- Legal range (intervallo legale): codifica la scala tonale dai valori 64 (parte bassa) a 940 (parte alta), lasciando un margine del –4% per la sottoesposizione e del +9% per la sovraesposizione.
- Full range (o extended range, intervallo completo): codifica il segnale dai valori 4 (parte bassa) a 1019 (parte alta), riservando i bit 0–3 e 1020–1023 per i segnali di sincronizzazione video.
Problemi comuni e soluzioni
La differenza tra queste due codifiche Rec.709 genera spesso confusione quando si passa dall’una all’altra, o quando le impostazioni del monitor o proiettore non corrispondono al tipo di segnale ricevuto. Nella maggior parte dei casi, l’intervallo legal range è la scelta corretta per i livelli video. Una scelta sbagliata si nota subito osservando i neri:
- Neri troppo scuri o “tagliati” (clipping) indicano che si sta visualizzando un segnale full range su un monitor impostato per legal range
- Neri “sollevati” o grigiastri indicano che si sta visualizzando un segnale legal range su un monitor impostato per full range
La scelta tra Data Level (full range) e Video Level (legal range) dipende quasi sempre dal codec utilizzato per registrare o esportare, e il 90% dei codec è progettato per i livelli video legali (Video Levels). Alcuni sistemi di elaborazione utilizzano tutti i 1024 valori di codice colore disponibili durante il processing interno, ma questa codifica non è uno standard ufficiale per la trasmissione broadcast.
Codifica Logaritmica per la Pellicola
Il sistema Cineon fu creato da Eastman Kodak all’inizio degli anni ’90 per risolvere il problema della codifica efficiente della luce lineare nel cinema digitale. Cineon fu uno dei primi sistemi digitali cinematografici completi a 4K con codifica a 10 bit log, interamente basato su computer e gestito end-to-end (dall’acquisizione alla distribuzione). Il sistema era composto da tre elementi integrati: uno scanner per pellicola, una workstation digitale con il software Cineon per compositing, effetti visivi, restauro e gestione del colore, e un registratore di pellicola per riportare il contenuto su supporto filmico.
Già alla fine degli anni ’80, il sistema Cineon aveva sviluppato una codifica logaritmica specifica per la scansione della pellicola cinematografica. Questa curva di codifica log divenne il modello di riferimento per tutte le successive codifiche logaritmiche utilizzate nelle videocamere digitali moderne.
Il progetto Cineon portò anche alla creazione del formato file Cineon (.cin) a 10 bit log, progettato specificamente per gestire i fotogrammi digitalizzati della pellicola. Questo formato divenne la base del successivo standard SMPTE Digital Picture Exchange (.dpx). I file Cineon e i file DPX sono molto simili tra loro e vengono spesso usati in modo intercambiabile. Entrambi i formati includono intestazioni (header) contenenti metadati con informazioni sul file e sul suo utilizzo. Le intestazioni dei file DPX sono più flessibili e adattabili alle esigenze di diverse industrie, mentre il formato Cineon è più specificamente orientato al cinema su pellicola.
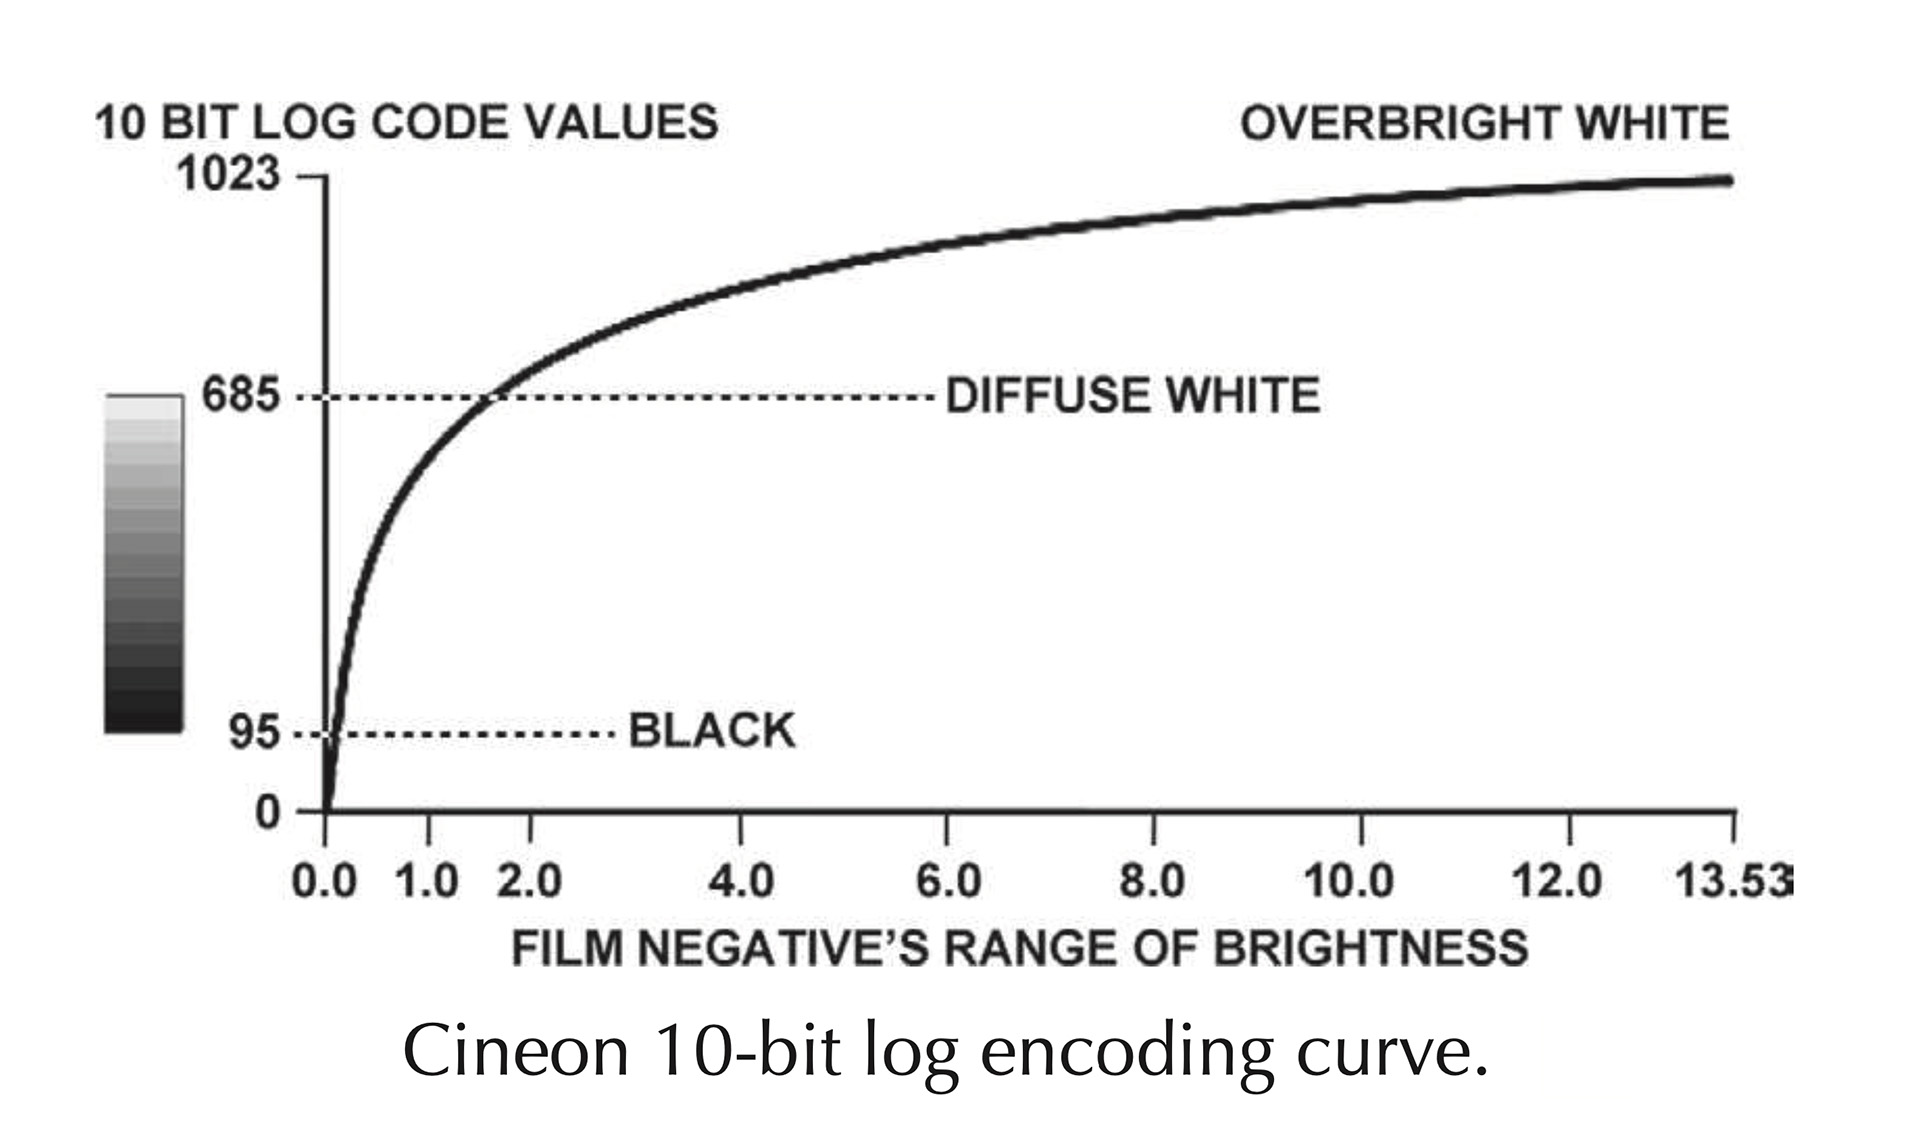
Formato File Cineon/DPX a 10 Bit Log
In un file Cineon (.cin o .dpx), ciascun canale colore (rosso, verde, blu) viene codificato con 10 bit, utilizzando tipicamente un intervallo che va dal “punto di nero” al valore 95 fino al “bianco diffuso” al valore 685, su una scala totale da 0 a 1023.
Il valore 685 (bianco diffuso) rappresenta una superficie bianca che riflette la luce in modo uniforme in tutte le direzioni, secondo una riflessione lambertiana. Questo tipo di riflessione è diversa dalle riflessioni speculari (come i riflessi su superfici lucide), che concentrano la luce in un’unica direzione.
Per rendere più naturale la transizione verso le zone molto luminose, fu introdotto un “soft clip” che gestisce gradualmente il passaggio ai bianchi estremi.
I valori superiori a 685 sono riservati ai toni “più chiari del bianco”, come i riflessi speculari o la luce diretta del sole.
I valori inferiori a 95 sono riservati alle informazioni “più nere del nero”.
Quando in laboratorio un negativo viene “stampato più chiaro” per ragioni artistiche o per uniformare i colori tra le scene, queste informazioni nascoste sotto il nero possono emergere e risultare visibili. Allo stesso modo, stampando un negativo “più scuro” è possibile recuperare dettagli dalle zone sovraesposte.
Le scansioni log Cineon catturano l’intera gamma di esposizione di ogni fotogramma di pellicola e la memorizzano come file a 10 bit log. Poiché il negativo cinematografico risponde alla luce in modo logaritmico (proprio come la visione umana), è il negativo stesso a determinare la forma della curva log. Il file digitale deve semplicemente registrare in modo fedele e accurato la densità del negativo a ogni livello tonale. Maggiore è l’esposizione alla luce, più valori di codifica vengono allocati in modo percettivamente utile.
La pellicola viene misurata in unità di densità logaritmica, proporzionali alla densità ottica del negativo. Quando si codifica la latitudine di esposizione della pellicola, è fondamentale distribuire con attenzione il numero di valori di codice per ogni stop di luce, in modo da utilizzare i bit disponibili nel modo più efficiente possibile.
Se si tentasse di comprimere l’intera gamma di luminosità della pellicola nell’intervallo completo 0–1023, rimarrebbero solo circa 75 valori di codice per rappresentare la gamma tra 0 e 1 stop, lo stesso numero di valori che verrebbero allocati per la gamma tra +12 e +13 stop. Ma le alte luci della pellicola non necessitano di così tanti valori di codice, e l’occhio umano non è in grado di distinguere tra due riflessi estremamente luminosi così vicini in intensità.
Poiché il nero è mappato al valore 95, rimangono solo 928 valori di codice disponibili per rappresentare tutta la restante gamma di esposizione. Nelle scene con luci estremamente intense, i valori possono superare l’intervallo standard Cineon: in questi casi, nelle codifiche DPX standard, quelle luci vengono perse per clipping (taglio).
L’enorme gamma dinamica della pellicola non avrebbe potuto essere preservata durante la post-produzione digitale senza caratterizzare accuratamente la risposta della pellicola (con la sua caratteristica curva a “S”, composta da spalla e piede) e senza codificarla in log. Per questo motivo Kodak sviluppò la curva di codifica log Cineon, in modo da conservare la massima latitudine della pellicola nelle scansioni digitali utilizzando un file log a 10 bit.
Intervalli di codifica Cineon/DPX
L’evoluzione delle videocamere digitali
Alla fine degli anni ’90 e nei primi anni 2000, le videocamere digitali hanno iniziato un’evoluzione che le avrebbe portate a competere con la pellicola cinematografica tradizionale e, in alcuni casi, a sostituirla completamente.
Nel 1998, la videocamera SONY F900 (con risoluzione 1920 × 1080) e i suoi registratori HDCAM rappresentavano una seria minaccia per la supremazia della pellicola. Tuttavia, uno dei principali ostacoli al suo successo nel mondo del cinema era il sistema di colore Rec 709, che si rivelò inadeguato per le esigenze cinematografiche.
Il caso Star Wars
Nel giugno 2000, Star Wars: Episodio II – L’attacco dei cloni iniziò le riprese interamente con una videocamera SONY HDW-F900, utilizzando il formato Rec 709 con registrazione su nastro HDCAM. Questo fu un momento storico: un grande film hollywoodiano girato completamente in digitale. Tuttavia, la F900 si rivelò rapidamente insufficiente per la qualità richiesta dal grande schermo cinematografico.
Questa esperienza accelerò lo sviluppo di nuove tecnologie. Divenne chiaro che per competere con la pellicola, le videocamere digitali avrebbero dovuto supportare un segnale a 10 bit con campionamento 4:4:4 (larghezza di banda completa per tutti i canali colore).
Nel 2005, l’American Society of Cinematographers e la Producers Guild of America organizzarono la ASC/PGA Camera Assessment Series, un test comparativo storico. Vennero messe alla prova sette videocamere digitali di punta:
- ARRI D-21
- Panasonic AJ-HPX3700
- Panavision Genesis
- Red One
- SONY F23 e F35
- Thomson Grass Valley Viper
Come termine di paragone, venne utilizzata una cinepresa ARRI 435 con quattro diverse pellicole Kodak: due per luce artificiale (tungsteno) e due per luce diurna (daylight).
Il passaggio alla codifica logaritmica
La decisione di gestire il materiale in post-produzione con un flusso di lavoro digitale simile a quello della pellicola impose una svolta fondamentale. Dove possibile, le videocamere dovevano registrare un segnale codificato logaritmicamente anziché con la tradizionale codifica Rec 709.
Ma cosa significa “codifica logaritmica”? È un metodo che imita le caratteristiche del negativo cinematografico, permettendo di:
- Riprodurre una gamma dinamica più ampia (più dettagli nelle zone molto scure e molto chiare)
- Catturare uno spazio colore più ricco, simile alla pellicola
Uno dei risultati più importanti di questi test fu l’impegno dell’industria a sviluppare codifiche log specifiche per il cinema e spazi colore più ampi, aprendo la strada al successo delle videocamere digitali nella produzione cinematografica professionale.
L’era delle codifiche log
Oggi, la presenza di codifiche log nelle videocamere da cinema digitali è diventata uno standard. Ogni videocamera che aspira a essere presa sul serio nel mondo del cinema offre il proprio sistema log. Vediamo i più importanti.
ARRI Log C
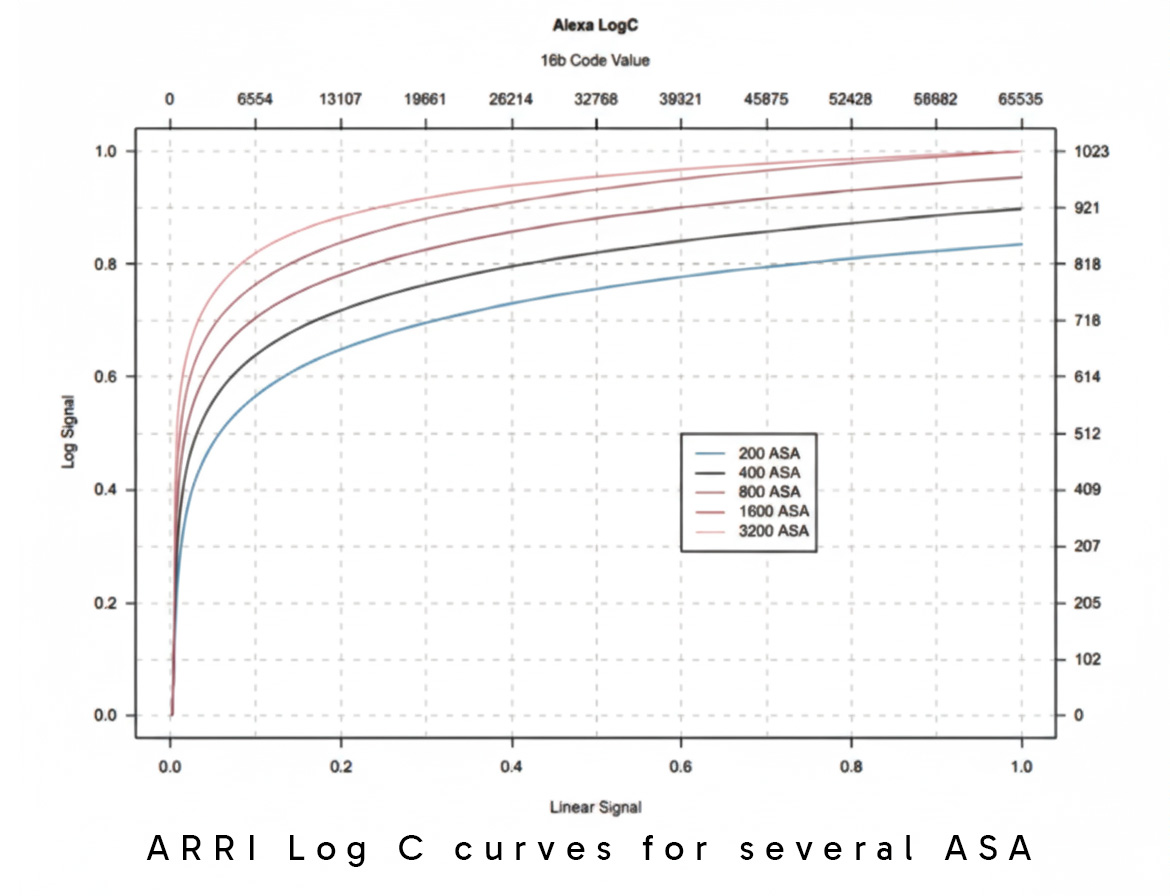
La curva Log C è una codifica logaritmica dei valori tonali della scena. La sua caratteristica principale è che la relazione tra l’esposizione (misurata in stop, le unità che indicano il raddoppio o dimezzamento della luce) e i valori numerici usati per codificare il segnale rimane costante su un ampio intervallo.
La forma della curva Log C è simile alla curva Cineon del negativo cinematografico, anche se le caratteristiche cromatiche sono diverse a causa delle differenze fondamentali tra un sensore digitale e la pellicola.
Come funziona Log C
Log C non è un’unica curva, ma un insieme di curve diverse per diversi valori di sensibilità (EI/ASA, simili agli ISO in fotografia). Ogni curva funziona secondo questo principio:
- Il segnale del sensore corrispondente a una luminanza del 18% di grigio (il grigio medio di riferimento) viene mappato a un valore di 400 in un segnale a 10 bit
- Un segnale a 10 bit offre 1024 valori totali (da 0 a 1023)
- Il valore massimo della curva cambia in base alla sensibilità impostata
Esempio pratico: Se chiudi il diaframma dell’obiettivo di uno stop e aumenti la sensibilità da EI 800 a EI 1600, il sensore catturerà uno stop in più di informazioni nelle alte luci (le zone luminose). Poiché Log C rappresenta i valori reali di esposizione della scena, il valore massimo della curva aumenta di conseguenza.

SONY S-Log
S-Log è in realtà una famiglia di tre curve (S-Log, S-Log2 e S-Log3), ciascuna ottimizzata specificamente per le videocamere cinematografiche SONY per massimizzare le prestazioni del sensore.
L’evoluzione delle curve S-Log
Le curve S-Log sono progettate con un obiettivo preciso: registrare e trasmettere quante più informazioni possibili catturate dal sensore, preservando tutto lo spazio colore e la gamma dinamica disponibili.
S-Log1: Il direttore della fotografia può preservare fino al 1000% della gamma dinamica dello standard Rec 709 (ovvero 10 volte superiore).
S-Log2: La gamma dinamica aumenta fino al 1500% rispetto a Rec 709.
S-Log3: Offre prestazioni simili a S-Log2, ma con importanti miglioramenti:
- Maggiori dettagli nelle ombre (zone scure)
- Gamma dinamica estesa tra toni medi e alte luci
Le caratteristiche tecniche di S-Log3
S-Log3 si basa sul sistema Cineon Digital Negative revisionato nel 2007 e presenta caratteristiche specifiche:
- Niente “shoulder” (la compressione graduale delle alte luci)
- “Toe” ridotto (la curva non lineare nell’area delle ombre è minimizzata)
Questo rende S-Log3 più simile a una codifica logaritmica pura rispetto a S-Log2, offrendo una maggiore flessibilità nella correzione colore in fase di post-produzione.
In sintesi: Le codifiche logaritmiche hanno rivoluzionato il cinema digitale, permettendo alle videocamere di catturare immagini con una qualità e una flessibilità paragonabili, e in alcuni casi superiori, alla tradizionale pellicola cinematografica.
Display Referred vs. Scene Referred
Quello che possiamo apprendere dall’evoluzione dalla codifica Rec 709 alla codifica log è che l’intento creativo della cinematografia ci ha spinti da un approccio di codifica percettiva Display Referred (ovvero “riferito al display”), in cui le immagini vengono trasformate direttamente per adattarsi alle caratteristiche non lineari dello schermo utilizzato, verso un approccio Scene Referred (ovvero “riferito alla scena”), in cui i dati dell’immagine vengono mantenuti in un formato che rappresenta il più fedelmente possibile i valori di luce reali della scena originale, preservando tutti i colori e l’ampia gamma dinamica catturati.
La codifica log cattura l’integrità delle immagini originali dalle videocamere digitali in modo più fedele rispetto alla codifica Gamma, e al contempo permette di memorizzare le immagini in file molto più piccoli rispetto alla codifica lineare (che registra i valori di luce così come sono fisicamente). Quindi, per ora, la codifica log ci offre il flusso di lavoro più efficace: massima qualità con dimensioni gestibili.
Ogni produttore comprende ormai che caratterizzare le prestazioni di un nuovo sensore e sviluppare una curva di codifica log specifica per quel sensore è una delle chiavi del successo di una videocamera.
Nota le variazioni in % IRE (l’unità di misura del segnale video, dove 0% è il nero e 100% è il bianco) e nei valori di codice numerici dal nero al grigio medio fino al bianco al 90% tra una codifica e l’altra. Le decisioni che i produttori di videocamere prendono nella codifica variano ampiamente da un modello all’altro. Una conseguenza diretta è che in post-produzione è necessario avere accesso ai profili di de-log accurati per ogni videocamera utilizzata, in modo da poter decodificare e correggere correttamente il colore delle immagini. Non è raro che una scena includa materiale girato con mezza dozzina di videocamere diverse, quindi l’accesso e l’uso dei corretti profili di codifica e decodifica è assolutamente imprescindibile.

Frequenza di campionamento video: cos’è e perché è importante
La frequenza di campionamento, o sampling rate, indica quanto frequentemente un sistema digitale misura un segnale analogico proveniente dal sensore della videocamera.
In parole semplici, il sensore riceve continuamente informazioni luminose, mentre il sistema digitale deve trasformarle in valori numerici. Per farlo, prende una serie di “campioni” del segnale a intervalli regolari.
Più campioni vengono acquisiti, più accurata sarà la rappresentazione digitale del segnale originale.

Perché il sampling rate è importante?
Possiamo immaginare un segnale analogico come un’onda continua. Il video digitale non registra tutta l’onda in maniera continua, ma ne misura alcuni punti.
Se i campioni sono troppo pochi, il sistema non riesce a ricostruire correttamente il segnale originale e possono comparire errori chiamati aliasing.
Al contrario, una frequenza di campionamento più elevata permette di rappresentare il segnale con maggiore precisione.
Questo principio è alla base della conversione da segnale analogico a video digitale.
Il teorema di Nyquist-Shannon
Il principio fondamentale del campionamento digitale è descritto dal teorema di Nyquist-Shannon.
Secondo questo teorema, per ricostruire correttamente un segnale analogico, la frequenza di campionamento deve essere almeno superiore al doppio della frequenza più alta contenuta nel segnale.
In pratica:
più alta è la frequenza del segnale da registrare, maggiore dovrà essere il sampling rate.
Se il campionamento è insufficiente, il sistema può interpretare erroneamente il segnale originale, generando aliasing e perdita di dettaglio.
Oversampling e qualità dell’immagine
Aumentare il numero di campioni migliora la precisione con cui il segnale viene digitalizzato. Questo processo viene spesso definito oversampling.
Un certo livello di oversampling può migliorare la qualità dell’immagine e ridurre alcuni artefatti, ma ha anche un costo: più informazioni devono essere elaborate e memorizzate.
Per questo motivo, nei sistemi video bisogna sempre trovare un compromesso tra:
qualità dell’immagine, quantità di dati e capacità di elaborazione.
Frequenza di campionamento e bitrate
La frequenza di campionamento non deve essere confusa con il bitrate.
Il sampling rate indica quanto frequentemente viene campionato il segnale, mentre il bitrate indica quanti dati vengono registrati o trasmessi ogni secondo.
Il bitrate viene normalmente espresso in:
Mb/s – megabit al secondo.
La quantità di dati di un video dipende da diversi fattori, tra cui:
- risoluzione;
- profondità in bit;
- frame rate;
- campionamento colore;
- compressione;
- codec utilizzato.
In generale, aumentando risoluzione, bit depth o frame rate aumenta anche la quantità di dati che il sistema deve elaborare.
Frequenza di campionamento in HD e UHD
Nei sistemi video broadcast Full HD 1920 × 1080, alcune frequenze di riferimento storiche sono pari a 74,25 MHz per la luminanza e 37,125 MHz per le componenti di crominanza nei segnali 4:2:2.
Con l’arrivo del 4K UHD 3840 × 2160, il numero di campioni complessivi aumenta notevolmente: l’UHD contiene infatti quattro volte il numero di pixel del Full HD.
Da non confondere con l’impostazione 50 Hz / 60 Hz presente nelle videocamere, che riguarda la famiglia di frame rate utilizzabili e la compatibilità con la frequenza della rete elettrica per evitare fenomeni di flicker. La frequenza di campionamento descritta qui, invece, è espressa in MHz e indica quante volte al secondo il segnale video viene campionato e convertito in dati digitali.
Le moderne videocamere cinematografiche utilizzano però sistemi di lettura del sensore e frequenze di campionamento molto più evoluti rispetto agli standard broadcast tradizionali.
In sintesi
La frequenza di campionamento video determina quanto accuratamente un sistema digitale riesce a trasformare il segnale proveniente dal sensore in dati digitali.
Un campionamento troppo basso può causare errori e aliasing, mentre un campionamento più elevato permette una rappresentazione più fedele dell’immagine.
In termini semplici:
più informazioni vengono campionate correttamente dal sensore, più accurata può essere la rappresentazione digitale dell’immagine.
Il vero limite è trovare il giusto equilibrio tra qualità, quantità di dati, spazio di archiviazione e potenza di elaborazione.
Colore
Le righe e le colonne di fotositi presenti su un sensore non sono, da sole, in grado di distinguere i colori.
Possono soltanto misurare individualmente l’intensità o l’energia della luce che li colpisce.
È quindi necessario fornire al sensore un sistema attraverso il quale ricavare le informazioni cromatiche.
La percezione del colore nell’essere umano ha origine da cellule specializzate presenti nella retina, chiamate coni, che contengono pigmenti caratterizzati da diverse sensibilità spettrali.
Nell’occhio umano esistono tre tipi di coni sensibili a tre differenti regioni dello spettro.
Questo sistema dà origine a quella che viene definita visione tricromatica.
I coni vengono classificati come:
- S – Short, sensibili alle lunghezze d’onda corte;
- M – Medium, sensibili alle lunghezze d’onda medie;
- L – Long, sensibili alle lunghezze d’onda lunghe.
Sebbene questi tre tipi di coni non corrispondano precisamente al rosso, verde e blu, costituiscono la base del modello cromatico RGB, che per l’essere umano rappresenta un metodo pratico per rappresentare visivamente il colore nelle immagini.
Per comprendere il funzionamento della fotografia a colori è importante comprendere come la luce visibile venga separata mediante filtri cromatici nei tre colori primari che utilizziamo per riprodurre le immagini:
rosso, verde e blu.
Analogamente a quanto avviene con i pigmenti presenti nei tre tipi di coni della retina, anche i filtri fotografici possono essere utilizzati per separare la luce nelle sue componenti cromatiche primarie.

Sensori CMOS con matrice Bayer
Quasi tutte le videocamere attualmente utilizzate nella cinematografia digitale impiegano un singolo sensore d’immagine CMOS — Complementary Metal-Oxide Semiconductor.
Le righe e le colonne di fotositi presenti sul sensore CMOS sono ricoperte da una matrice di filtri colore, chiamata Color Filter Array (CFA).
Questa matrice è composta da uno schema regolare e ripetitivo di microscopici filtri trasparenti:
rossi, verdi e blu.
Ogni fotosito può catturare soltanto la luce corrispondente a uno dei tre colori primari, mentre blocca la luce degli altri due.
Proprio come avviene sulla retina umana, i singoli filtri che separano rosso, verde e blu sono di dimensioni microscopiche.
Questa matrice di filtri colore viene normalmente organizzata secondo uno schema chiamato pattern Bayer, dal nome del suo inventore, il dottor Bryce Bayer di Eastman Kodak.
Una parte considerevole della luce che raggiunge una matrice di questo tipo viene inevitabilmente scartata.
Un fotosito verde può raccogliere soltanto la componente verde della luce che lo colpisce; la luce rossa e blu viene bloccata.
Un fotosito rosso può raccogliere soltanto la componente rossa; la luce verde e blu viene respinta.
Allo stesso modo, un fotosito blu può raccogliere soltanto la luce blu, respingendo quella rossa e verde.
In sintesi, un sensore con pattern Bayer è costituito da migliaia di righe e colonne di fotositi adiacenti, ma non coincidenti spazialmente, ricoperti da una matrice di filtri colore organizzata secondo uno schema ripetitivo di filtri rossi, verdi e blu.
Mediante questo sistema, il sensore Bayer campiona separatamente ciascuno dei tre colori primari utilizzando fotositi adiacenti.
Successivamente, le informazioni dei fotositi vicini vengono utilizzate per interpolare un valore RGB completo per ogni posizione dell’immagine.
A questo stadio, però, i fotositi non sono ancora pixel RGB completi.

Il colore nel dominio digitale: che cosa sono i pixel?
La parola pixel deriva dalla contrazione di:
pix, abbreviazione di pictures, e el, abbreviazione di element.
Un pixel è il più piccolo elemento a tre colori RGB indirizzabile all’interno di un dispositivo di imaging digitale.
L’indirizzo di un pixel corrisponde alle sue coordinate fisiche su un sensore o su uno schermo.
Il termine sensel deriva invece dalla contrazione di:
sens, da sensor, e el, da element.
Un sensel rappresenta il valore del segnale proveniente da un singolo elemento monocromatico del sensore che raccoglie fotoni.
In altre parole, il valore di un sensel è il valore del segnale elettrico prodotto da un fotosito.
In un sensore Bayer, ogni singolo fotosito può rilevare soltanto un colore:
- soltanto rosso;
- soltanto verde;
- oppure soltanto blu.

Di conseguenza:
i sensel e i fotositi NON sono pixel.
I pixel rappresentano invece campioni RGB a colori completi dell’immagine originale.
Un numero maggiore di pixel consente potenzialmente una rappresentazione più accurata dell’immagine originale.
Il colore e l’intensità tonale di un pixel possono variare.
Nei sistemi cinematografici digitali, un determinato colore viene normalmente rappresentato attraverso valori digitali, spesso codificati logaritmicamente a 10 bit per ciascuna delle tre componenti RGB: rosso, verde e blu.
Profondità colore in bit
La profondità colore in bit (color bit depth) indica il numero di gradazioni disponibili per rappresentare i valori di luminosità o la gamma tonale delle tre componenti RGB.
In altre parole, descrive la quantità di informazione cromatica memorizzata in ogni pixel.
Aumentando la profondità in bit aumenta il numero di colori che possono essere rappresentati.
In un’immagine RGB a 10 bit, ciascun canale — rosso, verde e blu — dispone di:
2¹⁰ = 1024 valori possibili.
Escludendo alcuni valori di codice riservati, ad esempio quelli compresi fra 0–4 e 1019–1023, è possibile ottenere fino a circa:
1.045.678.375 colori RGB differenti.
I fotositi NON sono pixel!
Una delle distinzioni più importanti quando si parla di videocamere cinematografiche digitali è la seguente:
i fotositi non sono pixel.
È importante ricordarlo quando un produttore dichiara, per esempio, che una videocamera possiede un sensore 4K.
Il direttore della fotografia dovrebbe approfondire per comprendere se il termine 4K faccia riferimento a:
4K di fotositi
oppure a
4K di pixel reali dell’immagine finale.
In questo libro, tali termini potrebbero talvolta essere utilizzati in maniera ambigua quando viene riportata direttamente la terminologia impiegata dai produttori.
Possedere un sensore con 4K di fotositi non significa necessariamente produrre un’immagine con 4K di risoluzione reale effettiva.
I pixel RGB completi devono essere creati partendo dalle immagini RAW Bayer attraverso un processo matematico che interpola i campioni provenienti dai fotositi adiacenti e non coincidenti:
- fotositi che registrano soltanto il rosso;
- fotositi che registrano soltanto il verde;
- fotositi che registrano soltanto il blu.
Questo processo matematico di combinazione e interpolazione dei valori prende il nome di deBayering, o demosaicizzazione.
I processi matematici di debayering combinano e mediano i valori dei fotositi adiacenti attraverso diversi algoritmi e, di conseguenza, influenzano anche la risoluzione reale effettivamente ottenibile.
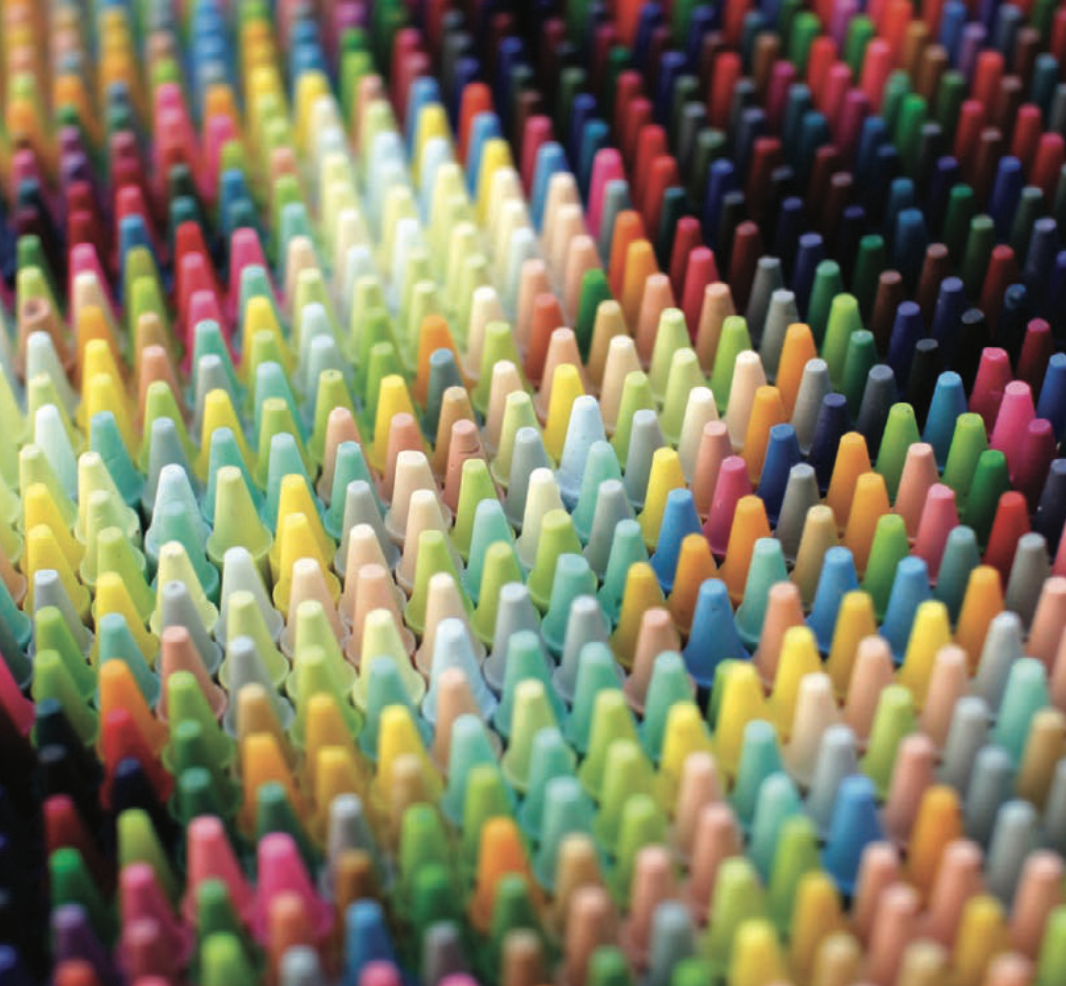
Profondità colore: quanti pastelli ci sono nella scatola?
Una maggiore profondità colore in bit permette di avere un numero maggiore di sfumature.
È come avere più pastelli nella propria scatola dei colori.
Come abbiamo visto in precedenza, la profondità in bit indica il numero di bit digitali utilizzati per memorizzare la scala tonale o le informazioni cromatiche di ogni pixel come rappresentazione digitale del mondo analogico.
Maggiore è la profondità in bit, maggiore sarà il numero di sfumature e la gamma di colori disponibili all’interno di un’immagine.
Di conseguenza, aumenterà anche la quantità di dati necessaria per memorizzarla.
La matematica del campionamento del colore
Se acquisiamo un numero sufficiente di campioni, con una frequenza sufficientemente elevata, e suddividiamo ciascuno di essi in un numero sufficientemente elevato di colori discreti, possiamo riprodurre le immagini con maggiore accuratezza.
Una profondità colore insufficiente — cioè un numero troppo basso di colori discreti disponibili — produce fenomeni di quantizzazione e banding cromatico.
In un’immagine, per esempio, invece di osservare una gradazione delicata tra differenti tonalità di rosso, potremmo vedere bande distinte e separate.
Una maggiore profondità colore significa che la codifica di ciascun canale — rosso, verde o blu — divide la scala tonale in un numero maggiore di valori discreti.
Di conseguenza, le differenze tra un valore e quello successivo diventano più piccole e il banding nelle gradazioni cromatiche sottili diventa meno visibile.
Utilizzando la metafora precedente:
più pastelli ci sono nella scatola, minore è la differenza di colore tra un pastello e quello successivo.
Più pastelli, immagini più belle
Se prendiamo abbastanza campioni con una frequenza sufficientemente elevata e suddividiamo ciascun campione in un numero sufficientemente elevato di colori discreti, possiamo riprodurre le nostre immagini in maniera più accurata.
La profondità in bit del campionamento del colore rappresenta il numero massimo di bit tonali disponibili per le componenti RGB di ciascun campione utilizzato per ricostruire le immagini dai dati digitali.
I sistemi di file DPX, utilizzati nel cinema digitale, possono operare con colore a 30 bit, cioè:
- 10 bit per il rosso;
- 10 bit per il verde;
- 10 bit per il blu.
Questi valori sono spesso codificati logaritmicamente.
Dei 1024 valori disponibili per ciascun canale, alcuni valori superiori e inferiori vengono riservati ad altri dati.
In termini approssimativi, un sistema RGB a 30 bit dispone quindi di circa:
1015 valori di rosso × 1015 valori di verde × 1015 valori di blu
per un totale di circa:
1.045.678.375 possibili tonalità di colore.
Quanto maggiore è il sovracampionamento dei segnali analogici, tanto più accuratamente possiamo ricostruire quei segnali a partire dai campioni digitali.
Il compromesso riguarda però lo spazio di archiviazione.
Se eseguiamo un sovracampionamento eccessivo, aumenta la quantità di dati necessaria per memorizzare le immagini.
Anche in questo caso si tratta quindi di un compromesso economico e tecnologico.
Un certo livello di oversampling può migliorare la qualità delle immagini, ma un sovracampionamento eccessivo spreca risorse e rallenta l’elaborazione.

ACES
Sono stati compiuti notevoli sforzi nella ricerca e nello sviluppo di sistemi destinati a rappresentare il futuro del cinema digitale, compresi formati e sistemi di elaborazione basati su valori floating point a 16 bit half-float per la manipolazione delle immagini.
La matematica in virgola mobile rappresenta i valori attraverso esponenti anziché utilizzare esclusivamente numeri interi.
Questo permette di eseguire numerose operazioni matematiche con una precisione molto maggiore, riducendo gli errori di arrotondamento e quantizzazione tipici dei calcoli effettuati con numeri interi.
Il progetto ACES — Academy Color Encoding System, sviluppato sotto l’egida dell’Academy of Motion Picture Arts and Sciences, nasce con l’obiettivo di creare un sistema universale per la gestione delle immagini cinematografiche digitali, utilizzabile lungo l’intera filiera:
dalla lavorazione delle immagini e dalla color correction fino all’archiviazione.
Una rappresentazione a 16 bit consente teoricamente:
2¹⁶ = 65.536 valori
per ciascuna componente.
Questo significa poter rappresentare:
- 65.536 livelli di rosso;
- 65.536 livelli di verde;
- 65.536 livelli di blu.
Ciò permette una precisione molto maggiore e gradazioni cromatiche estremamente più sottili.
Questo è particolarmente importante quando si lavora con spazi colore ad ampio gamut, nei quali numerosi colori devono essere rappresentati con grande precisione, oppure nei processi di Digital Intermediate, dove un’immagine può essere sottoposta consecutivamente a un elevato numero di trasformazioni matematiche.
Al momento descritto nel testo originale, ACES 2.0 era in fase di sviluppo e l’Academy of Motion Picture Arts and Sciences aveva avviato iniziative volte a rendere ACES disponibile pubblicamente attraverso progetti open source legati all’Academy Software Foundation.
In questo articolo abbiamo seguito il percorso che porta la luce reale a diventare un’immagine digitale, analizzando il ruolo di sensore, campionamento, quantizzazione, profondità in bit e debayering.
Abbiamo visto come curve gamma e Log permettano di distribuire meglio le informazioni disponibili e di preservare una maggiore gamma dinamica, lasciando più libertà alla post-produzione.
Infine, abbiamo affrontato l’evoluzione dai workflow Display Referred ai sistemi Scene Referred e al color management con ACES, pensati per mantenere coerenza tra camere, spazi colore e dispositivi di visualizzazione.
In sintesi, comprendere questi concetti significa capire come il cinema digitale trasforma la luce in dati e come questi dati vengono gestiti per preservare il più possibile qualità, gamma dinamica e intenzione fotografica fino all’immagine finale.